Echtzeit-Industriebildverarbeitung mit FPGA: vom GigE-Kamerabild bis zur Fehlerkalibrierung
Wo ist der FPGA entlang der Prüfstrecke vom Kamerapixel bis zum Ausschleusesignal unersetzlich? Dieser Artikel rechnet zuerst die Bandbreitenbilanz des gesamten Datenstroms auf, zerlegt dann die vier Rollen des FPGA in der Bildverarbeitungsstrecke, vergleicht die Echtzeitgrenzen klassischer Verfahren und Deep Learning und zeigt am Beispiel einer Lotsen-AOI-Station an der PCB-Lötstelle eine praxisnahe Hardware-Auswahl.
1. Zuerst die Bandbreitenrechnung: der Datenstrom einer 1080p60-Linie
Die erste Hürde der industriellen Bildverarbeitung ist nicht der Algorithmus, sondern die Bandbreite. Rechnen wir mit der einfachsten Strecke—einer einzelnen 1080p-, 60fps-GigE-Vision-Kamera—und bestimmen ihre Datenrate:
| Ausgabeformat | Berechnung | Ergebnis | Über Gigabit-Link? |
|---|---|---|---|
| 8-Bit-Bayer (üblich) | 1920 × 1080 × 8 Bit × 60 | ≈ 995 Mb/s ≈ 124 MB/s | 99,5 % von 1 Gbps belegt, gerade so |
| 12-Bit-Bayer (HDR/Dunkel) | 1920 × 1080 × 12 Bit × 60 | ≈ 1,49 Gb/s ≈ 187 MB/s | Über Gigabit; nötig sind 2,5G/10G oder CoaXPress |
| 4 × 8-Bit-Kameras | 995 Mb/s × 4 | ≈ 4 Gb/s ≈ 500 MB/s | Erforderlich sind 4× Gigabit-Bündelung oder 10G-Uplink |
Übergibt man diese Rohbilder unverändert an CPU oder GPU, schleppt jeder Kanal 124–187 MB/s; vier Kanäle ergeben 500 MB/s. Auf der CPU-Seite muss dann noch ein vollständiger Frame verarbeitet werden—Bandbreite und Rechenleistung brennen an beiden Enden. Was die Fehlererkennung wirklich braucht, ist nur: wo ist die Anomalie, welcher Typ, welche Koordinaten—oft nur wenige hundert Byte.
Der Schlüssel: Wo Pixel bearbeitet werden, bestimmt die Gesamtkosten der Strecke
Rohbilder wegzubewegen und später zu bearbeiten ist die „Träger“-Denke; Pixel dort zu verarbeiten, wo sie vorbeifließen, ist die „Strecken“-Denke. Ersteres addiert pro Kamera einen vollen Kanal an Bandbreite und Rechenlast; letzteres nur Logik.
2. Die vier Rollen des FPGA in der Bildverarbeitungsstrecke
Rolle 1: Anbindungen und Mehrkamera-Synchronisation
Protokoll-Dekodierung für GigE Vision / CoaXPress, Kameraparameter-Konfiguration und Triggerführung übernimmt die MAC-Schicht samt Triggerlogik direkt im FPGA. Mehrere Kameras sperren sich auf denselben Hardware-Trigger-Takt—Aufnahmen aus verschiedenen Blickwinkeln werden exakt im selben Moment belichtet, eine Eigenschaft, die softwareseitig kaum deterministisch zu erreichen ist.
Rolle 2: Bildvorverarbeitung (Rauschunterdrückung, Gain, Bayer-Interpolation)
Rauschunterdrückung, Weißabgleich, Gain, Bayer-Interpolation, ROI-Extraktion—alles pro-Pixel-Operationen. Die FPGA-Pipeline rechnet naturnah ein Pixel pro Takt; der Pixeltakt bei 1080p60 liegt bei rund 148,5 MHz, deutlich im Timing-Marginal von Bausteinen wie dem JFM7K410T. Dieselbe Pro-Pixel-Arbeit kostet auf der CPU mehrere bis zig Millisekunden pro Frame; auf dem FPGA eine fest bestimmte Latenz von wenigen Dutzend Taktzyklen.
Rolle 3: Fehlererkennung (Schablone, Differenz, Zusammenhangsanalyse)
Schablonenabgleich, Bilddifferenz, Schwellwert, Zusammenhangsanalyse, morphologische Verfahren—alles parallel und pipelinefähig. Der Schablonenabgleich auf einem 1080p-Bild läuft auf dem FPGA in unter 1 ms pro Frame, Latenz unabhängig von der Bildrate und vollständig deterministisch—ein hartes Kriterium für den Takt der Linie.
Rolle 4: Ergebnisausgabe und IO-Anbindung
Das Urteil steuert direkt Ausschleuser, Warnleuchte und Zähler. Die GPIO-Ausgänge des FPGA schalten auf Nanosekunden-Ebene, ohne Umwege über Betriebssystem, Treiber oder Anwendungsschicht. In dem Moment, in dem der Fehler erkannt wird, ist das Ausschleusesignal bereits am Aktor.
3. Zwei Algorithmenwege: klassische Bildverarbeitung vs. Deep Learning
„Einfach Deep Learning“ ist in den letzten Jahren zum Mantra geworden; doch die Echtzeitgrenze zwischen beiden Wegen muss klar gezogen werden:
| Dimension | Klassische Bildverarbeitung (Schablone/Differenz/Morphologie) | Deep Learning (CNN/YOLO-Klasse) |
|---|---|---|
| 1080p-Frame-Latenz | <1 ms (FPGA-Pipeline) | 2–10 ms (GPU) oder höher (allgemeines NPU) |
| Ressourcenbedarf | Wenige LUT/DSP | Viele DSPs + externe Speicherbandbreite |
| Interpretierbarkeit | Schwellwerte einstellbar, Fehler rückverfolgbar | Black Box, Fehlalarme schwer lokalisierbar |
| Einsatzbereich | Feste Fehlermuster, getaktete Linien | Komplexe Fehler, Offline-Nachprüfung variabler Proben |
| Auf dem FPGA | Ausgereift, hoher Engineering-Grad | Benötigt Quantisierung/Pruning, meist auf CPU/GPU |
Die Mainstream-Architektur 2026 ist FPGA-Vorverarbeitung + klassische Echtzeitentscheidung + Deep-Learning-Offline-Nachprüfung: Der FPGA garantiert Urteil und Ausschleusung innerhalb des Taktes, Deep Learning macht die Zweitprüfung auffälliger Regionen—jeder macht, was es am besten kann.
4. Ein realer Fall: AOI-Station an der PCB-Lötstelle
Projektfall · 01: SMT-Lötstellenprüfung—60 fps Dauerlauf, Falschmeldung < 0,5 %
An einer SMT-Linie soll eine AOI-Station Kaltrlötstellen, Lötbrücken und fehlende Bauteile erkennen, dauerhaft mit 60 fps laufen, Falschmeldungen unter 0,5 % und die Fehlerrate bei Kalrlötstellen unter 1 % bleiben.
- Kameras: 2 × GigE-20-MP-Industriekameras, effektiv auf 1080p-ROI beschnitten, 8-Bit-Bayer-Ausgabe
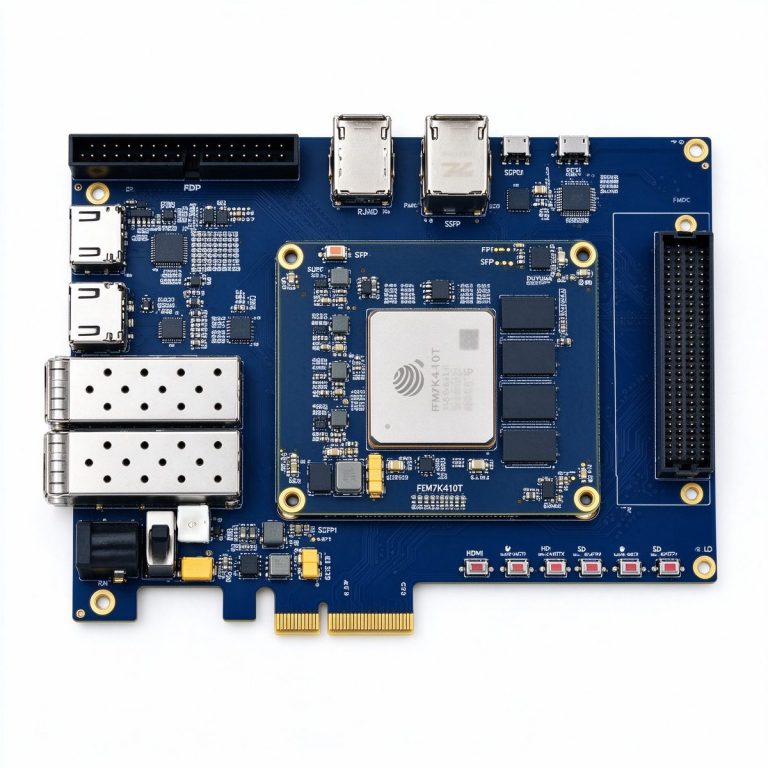
- Board: DUK7410T (Fudan Micro JFM7K410T, 406K Logiczellen, FMC HPC, 4 GB DDR3)
- Datenstrom: 2 × 995 Mb/s ≈ 2,5 Gb/s in den FPGA → DDR-Framepuffer → Schablonendifferenz + Zusammenhangsanalyse → Urteilsausgabe
Messwerte: Einzelbildverarbeitung < 0,8 ms; End-zu-End-Latenz vom Kamera-Trigger bis zum Ausschleusesignal < 1,5 ms; Falschmeldung < 0,5 %, Erkennung Kalrlötstellen > 99 %.
Gegenüber CPU: Die End-zu-End-Latenz sank von rund 15 ms auf < 1,5 ms, die CPU-Last des Hosts von 85 % auf 5 %—die ursprüngliche Software-Strecke schaffte nur 30 fps; mit FPGA verdoppelte sich der Durchsatz.
Der Schlüssel dieser Station ist kein schlauer Algorithmus—vielmehr, dass die Prüfaktion mit dem Linientakt mitkommt. Sobald ein fehlerhafter Frame anliegt, müssen Urteil und Ausschleusung vor dem nächsten Frame abgeschlossen sein.
5. Hardware-Auswahl: drei Boards, drei Strategien
Die Auswahl folgt drei Fragen: wie viele Kameras? wie hart ist die Latenzanforderung? wie hoch ist das Maschinenbudget? Hier die drei üblichen Plattformen von Duyuante:
DUK7410T (¥9.999)—solides Mittelklasse-Modell, Standard für 1/2-Kamera-AOI
Fudan Micro JFM7K410T, 406K Logiczellen, 1.540 DSP, FMC HPC, HDMI-4K-Eingang, 2× SFP+. FMC HPC führt direkt zu Hochgeschwindigkeitskamera- oder ADC-Tochterkarten, der HDMI-4K-Eingang kann gleichzeitig als Display-Loopback dienen. Bildpositionierung, Fehlererkennung, Mehrspur-Stitching-Prototypen—die meisten Projekte beginnen auf diesem Board.
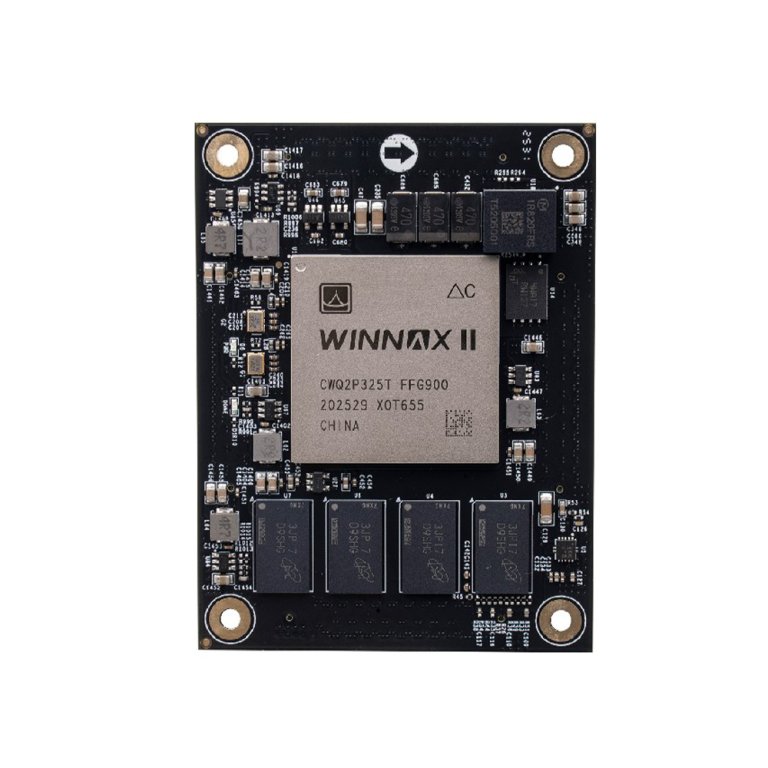
PBC7K325G (¥1.999)—Kostensensitive Maschinenintegration
China-Kintex-7-SoM, 326K Logik, 16 GTX-Transceiver, 2 GB DDR3, IndustrieTemperaturbereich −40 bis 85 °C. Einzelkamera mit festem Fehlermuster im eingebetteten Einsatz oder kombinierte Bildverarbeitungs- und Bewegungssteuerungs-Controller. Kostensensitive Produkte kommen von hier.
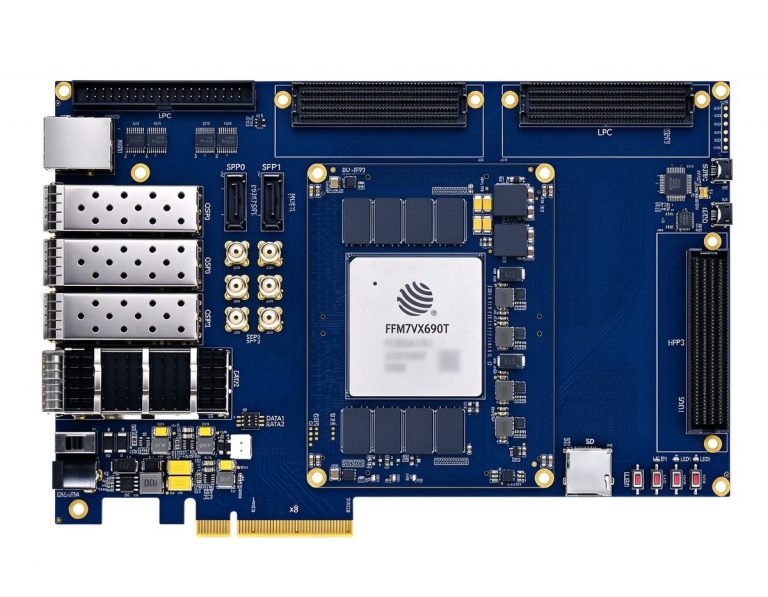
DUF7690T (¥24.999)—Mehrkamera-Arrays und leistungsfähige Kompositsysteme
Fudan Micro JFM7VX690T, 693K Logiczellen, 3.600 DSP, 36 GTH-Paare, QSFP 40G. Für 8+ Kamera-Arrays, 8K-Stitching oder kombinierte Bildverarbeitungs- und Glasfaser-Kommunikationssysteme—wenn große Logik und große Bandbreite nötig sind, ist dieses Board die nächste Stufe.
Das erste Prinzip der industriellen Bildverarbeitung lautet: „Ganze Frame nicht hin- und herschieben“—Pixel dort verarbeiten, wo sie vorbeifließen, dann verschwinden Latenz-, Bandbreite- und Leistungsprobleme zugleich.
>
— F&E-Team von Duyuante