PCIe-Bandbreitenplanung: Wie viel Nettbandbreite steckt wirklich in Gen3 x4 bis x16?
Die PCIe-Bandbreite ist komplexer als die Zahl im Datenblatt—Rohbandbreite, Codierungs-Overhead, Protokoll-Overhead, DMA-Effizienz und DDR-Engpass fressen alle von den versprochenen „16 GB/s”. Dieser Artikel rechnet Gen3 x4/x8/x16 durch, bis zur Abstimmung von DDR und DMA, und gibt eine wiederverwendbare Methode zur Nettbandbreiten-Abschätzung.
1. Drei Bandbreiten-Ebenen: Rohwert, codiert, netto
Wenn Sie im Datenblatt „PCIe Gen3 x16″ sehen, denkt man an 16 GB/s. Diese Zahl ist aber die Rohbitrate, nicht die nutzbare Bandbreite. Dazwischen liegen zwei Verlustebenen:
| Ebene | Gen3 x16 Rechnung | Ergebnis | Bedeutung |
|---|---|---|---|
| ① Rohbitrate | 16 Lanes × 8,0 GT/s | 128 Gb/s | Rohe Symbolrate auf dem Link |
| ② Bandbreite nach Codierung | 128 × 128/130 (Gen3 nutzt 128b/130b) | ≈ 126 Gb/s ≈ 15,75 GB/s | Nutzdatenrate nach Codierungs-Overhead |
| ③ Tatsächliche Nettbandbreite | 15,75 × Übertragungseffizienz (80–90 %) | ≈ 12,6 – 14,2 GB/s | Wirklich nutzbare Bandbreite nach TLP-Köpfen, DMA-Deskriptoren, Interrupts |
Gen3 läuft mit 8,0 GT/s pro Lane und nur 1,5 % 128b/130b-Overhead—deshalb ist Gen3 so viel effizienter als Gen2 (20 % 8b/10b-Overhead). Breitenvergleich:
| PCIe-Breite | Rohbitrate | Bandbreite nach Codierung | Typische Nettbandbreite (Block-DMA) |
|---|---|---|---|
| Gen3 x4 | 32 Gb/s | ≈ 3,94 GB/s | ≈ 3,2 – 3,5 GB/s |
| Gen3 x8 | 64 Gb/s | ≈ 7,88 GB/s | ≈ 6,3 – 7,1 GB/s |
| Gen3 x16 | 128 Gb/s | ≈ 15,75 GB/s | ≈ 12,6 – 14,2 GB/s |
| Gen2 x8 (Vergleich) | 40 Gb/s | ≈ 4,0 GB/s (8b/10b) | ≈ 3,2 – 3,6 GB/s |
2. Wie viel Protokoll-Overhead: TLP, Payload, Lese- vs Schreibrichtung
Bandbreite nach Codierung ist nicht Nettbandbreite. Jedes PCIe Transaction Layer Packet (TLP) trägt einen 12–20-Byte-Kopf; je größer das Payload, desto geringer der Kopf-Anteil und desto höher die Effizienz.
Payload-Größe bestimmt die Effizienz direkt
| Payload-Größe | TLP-Kopf-Anteil | Übertragungseffizienz | Typisches Szenario |
|---|---|---|---|
| 4 KB (max) | ≈ 0,4 % | ≈ 90 %+ | Große kontinuierliche DMA-Erfassung, Videoströme |
| 512 B | ≈ 3 % | ≈ 85–88 % | Allgemeine Datenrückführung |
| 64 B | ≈ 25 % | ≈ 55–65 % | Register-Lese-/Schreibzugriffe, Small-Packet-Steuerung |
Lesen ist langsamer als Schreiben: die versteckten Kosten von Completion
PCIe-Schreibtransaktionen sind Fire-and-Forget; der Sender wartet nicht auf Bestätigung. PCIe-Lesezugriffe müssen auf ein Completion-TLP warten—eine Hin- und Rückrunde, die Latenz und Bandbreite verdoppelt. Messwerte:
- Große sequenzielle Schreibvorgänge: 88–92 % der codierten Bandbreite
- Große sequenzielle Lesezugriffe: nur 80–85 % (Completion-Warteschlange, Overhead)
- Gemischte Lese-/Schreibzugriffe: Richtungswechsel verursacht Link-Pausen, Effizienz weiter −5–10 %
In der Planung gilt die konservative Schätzung „Nettbandbreite = codiert × 80 %”, nicht der Idealwert von über 90 %.
3. DDR ist die wahre Deckenhöhe
Ein schneller PCIe-Link bedeutet nicht, dass das System voll läuft—Daten in und aus dem FPGA müssen durch DDR, und die DDR-Bandbreite ist oft die erste Wand, an die man stößt.
DDR-Bandbreite berechnen
DDR-Bandbreite = Datenbreite × Datenrate / 8. Am Beispiel gängiger Duyuante-Boards:
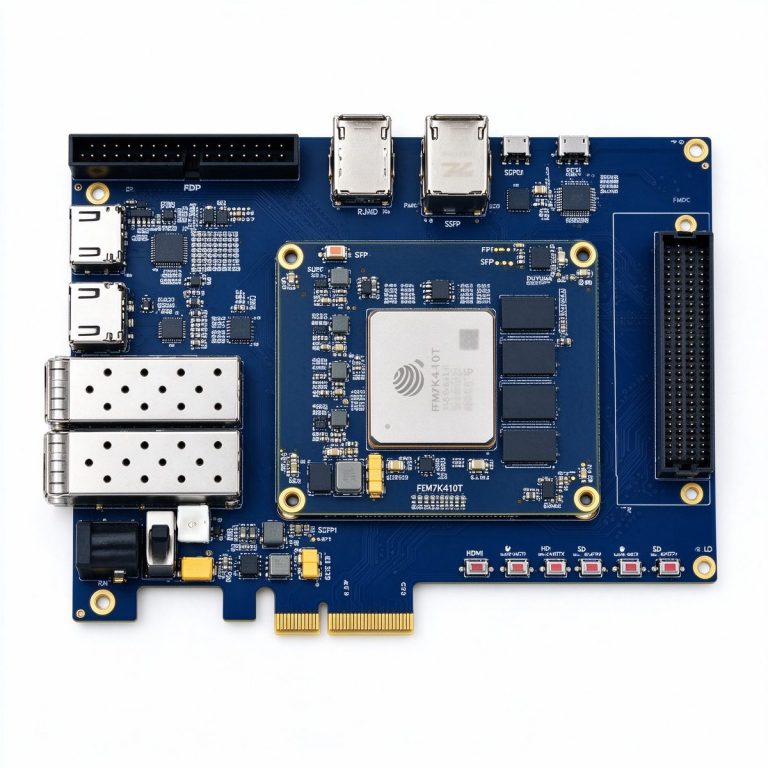
- DUK7410T: 4 GB DDR3, 64-bit, 1866 Mbps → 64 × 1866 / 8 ≈ 14,9 GB/s
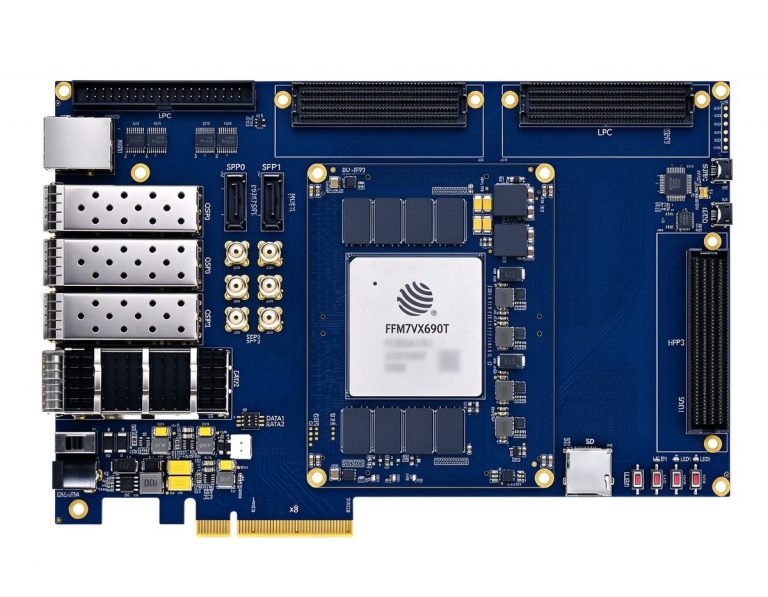
- DUF7690T: 4 GB DDR3, 64-bit, 1866 Mbps → ≈ 14,9 GB/s
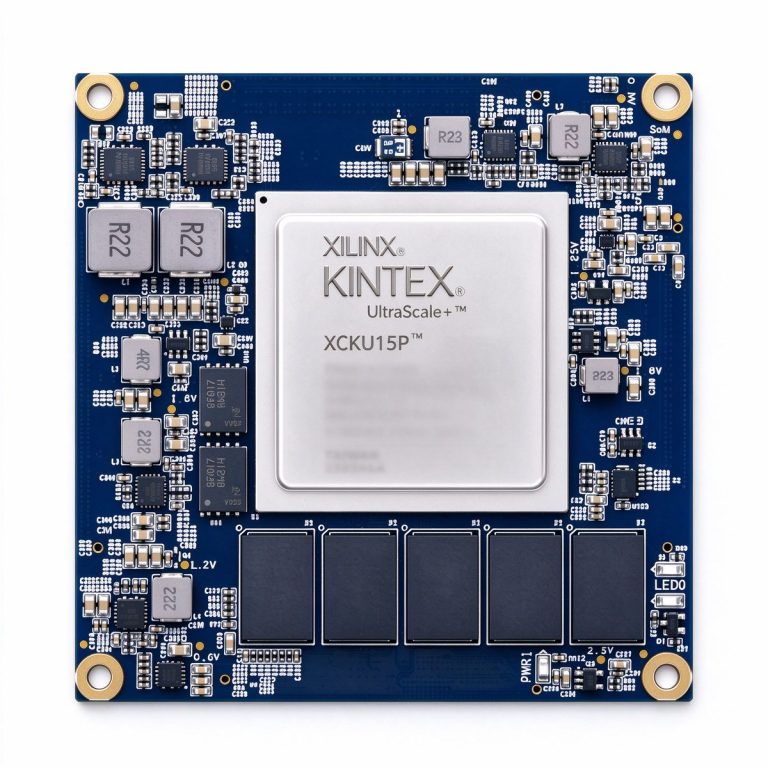
- DUKU15P: 8 GB DDR4 ECC, 64-bit (+8-bit ECC) → bei 2400 MT/s ≈ 19,2 GB/s
Der Datenfluss ist bidirektional: Lesen + Schreiben verdoppeln die Last
Stellen Sie sich ein Hochgeschwindigkeits-Erfassungsszenario vor: ADC-Daten werden vom FPGA verarbeitet und über PCIe an den Host zurückgeschrieben. Dieser Datenpfad kreuzt DDR zweimal:
- FPGA empfängt Daten → DDR-Schreiben (Framepuffer)
- FPGA schließt Verarbeitung ab → DDR-Lesen (Abholung zur Übertragung)
- Gesamte DDR-Last = Schreibbandbreite + Lesebandbreite
Wenn PCIe x8 Gen3 eine Nettbandbreite von 7 GB/s hat, muss DDR gleichzeitig 7 GB/s schreiben und 7 GB/s lesen = 14 GB/s—nahe der physikalischen DDR3-Grenze von 14,9 GB/s, kaum Reserve für FPGA-Algorithmen. Deshalb ist x8 Gen3 mit DDR3 das „Goldene Gespann”, während x16 DDR4 erfordert.
| Board | PCIe-Spezifikation | Codierte Bandbreite | DDR-Auslegung | DDR-Bandbreite | Abstimmungsurteil |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4,0 GB/s | 4 GB DDR3 64-bit | ≈ 14,9 GB/s | PCIe ist der Engpass, DDR hat Reserve |
| DUF7690T | Gen3 x8 | ≈ 7,88 GB/s | 4 GB DDR3 64-bit | ≈ 14,9 GB/s | ~7,5 GB/s pro Richtung, gerade ausbalanciert |
| DUKU15P | Gen3 x16 | ≈ 15,75 GB/s | 8 GB DDR4 64-bit | ≈ 19,2 GB/s | DDR nah an der Grenze bei voller PCIe-Last |
4. Dreistufige Abschätzung: Wie viel Bandbreite braucht Ihr Projekt?
Methodik · 01: PCIe-Bandbreitenabschätzung in drei Schritten
Schritt 1: Nettobedarf berechnen. Summieren Sie die Rohdatenraten aller Quellen—das Mindestvolumen, das bewegt werden muss.
Schritt 2: Redundanzfaktor anwenden. Multiplizieren Sie mit 1,2–1,5 für Overhead, Bursts und Duplex.
Schritt 3: PCIe-Breite zurückrechnen. Wählen Sie eine Spezifikation, bei der die codierte Bandbreite ≥ dem redundanten Bedarf entspricht, und prüfen Sie dann, ob DDR mithalten kann.
Validierung an drei Szenarien:
| Szenario | Rohdatenrate | Bedarf nach Redundanz | Empfohlenes PCIe | Begründung |
|---|---|---|---|---|
| Hochgeschwindigkeits-Erfassung (2ch × 250 MSPS × 14 Bit) | ≈ 875 MB/s | ≈ 1,1 – 1,3 GB/s | Gen3 x4 (3,94 GB/s) | Reichlich Reserve, DDR ohne Druck |
| 4K60-Videoerfassung und -verarbeitung (10 Bit 4:2:2) | ≈ 1,5 GB/s | ≈ 1,8 – 2,3 GB/s | Gen3 x8 (7,88 GB/s) | Platz für Mehrkanal-Video oder Stitching |
| KI-Inferenz-Feature-Maps / 8K-Videostrom | ≈ 10 – 12 GB/s | ≈ 12 – 18 GB/s | Gen3 x16 (15,75 GB/s) | Erfordert DDR4, sonst stößt DDR zuerst an die Wand |
Faustregel: Bei der PCIe-Breitenwahl vom Nettobedarf × 2 ausgehen und einen vollen Faktor Reserve lassen. Bandbreite kann man nachrüsten, Breite nicht ohne Redesign.
5. Auswahl zwischen drei Duyuante-PCIe-Plattformen
DUK7410T (¥9.999)—Kostensensitive Erfassung und Verarbeitung
Fudan Micro JFM7K410T, PCIe-Gen2-x8-Hard-IP, ca. 4 GB/s codiert. Mit FMC-HPC-Tochterkarten für Hochgeschwindigkeits-ADC-Erfassung oder HDMI-4K-Videoverarbeitung—hier startet man, wenn PCIe nicht der Engpass ist.
DUF7690T (¥24.999)—Haupt-Erfassung und Kompositverarbeitung
Fudan Micro JFM7VX690T, PCIe-Gen3-x8-Hard-IP, ca. 7,88 GB/s codiert. Mit 4 GB DDR3 bei ~7,5 GB/s pro Richtung—passt zur vollen x8-Bandbreite. Hauptplattform für Mehrkanal-Erfassung, Radar-Signalverarbeitung und Video-Stitching.
DUKU15P (¥15.999)—High-End-Datenrückführung und 100G-Anbindung
AMD Kintex UltraScale+ XCKU15P, PCIe-Gen3-x16-Hard-IP, 15,75 GB/s codiert, mit 8 GB DDR4 ECC. Integriert 56 Hochgeschwindigkeits-Transceiver (24× GTY 28G + 32× GTH 16G) und 4× 100G-Ethernet-Hard-IP—Flaggschiff für große PCIe-Rückführung plus Hochgeschwindigkeitsnetzwerk.
PCIe-Bandbreite ist nie nur „Schnittstellengeschwindigkeit”—sie ist das kürzeste Brett aus „Schnittstelle × Speicher × DMA”. Planen Sie zuerst die DDR-Reserve, dann reden Sie über PCIe-Tempo.
>
— F&E-Team Duyuante