10G/25G-Faser-Backhaul: GTX/GTH-Linienrate und UDP-Offload planen
Wenn mehrere Hochgeschwindigkeits-ADCs, Radarstrahlen oder Videoströme zusammenkommen, stößt Kupferkabel nach wenigen Metern an seine Grenze, und PCIe verlässt das Gehäuse nicht. Der richtige Backhaul treibt SFP+/QSFP direkt über die GTX/GTH-Transceiver des FPGA, lagert MAC- und IP/UDP-Stack on-Chip aus und sendet nur die Nutzlast mit Linienrate über die Faser. Dieser Artikel rechnet 10G/25G-Linienrate, UDP-Nutzlast, Link-Budget und die interne Arbeitsteilung des FPGA durch.
1. Warum Hochgeschwindigkeitsdaten über Faser zurückgehen
Innerhalb der Karte nutzt man PCIe, kurze Verbindungen zwischen Karten Kupfer; sobald Erfassungsknoten verteilt sind, die Entfernung einige Meter überschreitet und jeder Kanal mehrere Gb/s erreicht, stoßen Kupfer und Backplane zuerst an ihre Grenze:
1. Entfernungsgrenze: ein DAC-Kabel unterstützt bei 10G meist nur 3–5 m, auch aktives Kupfer ist begrenzt; Singlemode-Faser mit Optikmodule erreicht problemlos 10 km und passt zu verteilten Erfassungsarrays und entfernten Radarfronten.
2. Bandbreitengrenze: ein einzelnes 1080p60, mehrkanaliges SDR-ZF oder zusammengeführtes Radar-IQ überschreitet oft 10 Gb/s; Gigabit-Kupfer und Backplane tragen das nicht, man braucht SFP+ (10G) oder QSFP28 (25G/100G).
3. Zeitverhalten und Störfestigkeit: in rauer Industriebucht bietet Faser galvanische Trennung, Immunität gegen Übersprechen und Erdschleifen und stabilere gemeinsame Taktung über Knoten hinweg.
Typisches Bild: eine entfernte Erfassungskarte macht nur ADC-Abtastung und Vorverarbeitung, verpackt Ergebnisse und sendet sie über eine Faser an einen zentralen Server, der keine Kanäle einzeln verarbeitet, sondern nur den aggregierten Strom empfängt. Hier bestimmen Linienrate und Protokoll-Overhead direkt, wie viele Knoten anschließbar sind.
2. 10G/25G-Linienrate und UDP-Nutzlast-Budget (zuerst Nutzlast rechnen)
Viele halten einen „10-Gb/s-Port” für nutzbare Bandbreite; tatsächlich erreicht die Anwendungsschicht nur die Nutzlast nach Kodierung, Zwischenlücke und Protokollköpfen. Zuerst, wie die Linienrate entsteht:
| Position | 10G (SFP+) | 25G (QSFP28) | Hinweis |
|---|---|---|---|
| Nominelle Ethernet-Rate | 10,0 Gb/s | 25,0 Gb/s | Effektive MAC-Rate |
| 64b/66b codierte Linienrate | 10 × 66/64 = <span class=”hl”>10,3125 Gb/s</span> | 25 × 66/64 = <span class=”hl”>25,78125 Gb/s</span> | Tatsächliche Bitrate auf der Leitung |
| MTU 1500 Frame-Overhead | Präambel/SFD 8B + Lücke 12B + Eth 14B + IP 20B + UDP 8B | gleich | ~62B Nicht-Nutzlast je Frame |
| UDP-Nutzlast-Anteil | 1500/(1500+62) = <span class=”hl”>96,03%</span> | ≈96,03% | ohne Anwendungs-Retransmission |
| UDP-Nutzlast-Rate (MTU1500) | 10 × 96,03% ≈ <span class=”hl”>9,60 Gb/s</span> | 25 × 96,03% ≈ <span class=”hl”>24,0 Gb/s</span> | was die Anwendungsschicht wirklich erhält |
| Jumbo Frame (9000B) Anteil | 9000/9062 = 99,32% | 99,32% | hebt Nutzlast auf ~9,93 / ~24,8 Gb/s |
Kernschluss: über MTU1500-UDP liefert ein 10G-Port der App nur ~9,6 Gb/s, nicht 10 Gb/s. Knoten nach Nutzlast bemessen: sendet jeder Knoten 2 Gb/s effektive Daten, fasst eine 10G-Leitung etwa 4–5 Knoten (9,6 / 2, mit Reserve), nicht volle 5. Um nahe an die Linienrate zu kommen, Jumbo Frame aktivieren, um den festen Overhead je Frame zu verteilen.
BER und Link-Budget
Eine Faserleitung ist nicht fertig, sobald sie gesteckt ist; zuerst das optische Leistungsbudget rechnen: Sendeleistung − Empfangsempfindlichkeit = Link-Marge, davon Faser-Dämpfung (Singlemode 1310 nm ≈ 0,35 dB/km) und Spleiß-/Steckverluste (~0,5 dB je Stecker) abziehen. SR-Multimode 850 nm ist durch Distanz und OM3/OM4 begrenzt; LR-Singlemode 1310 nm reicht 10 km. Konforme Leitungen zielen auf BER besser als 1e-12; 25G nutzt üblicherweise RS-FEC und korrigiert Rohfehler ~1e-5 auf 1e-15, den FEC-Code-Gewinn ins Budget einrechnen.
3. Wie der FPGA die Arbeit teilt
1. GTX/GTH-Transceiver treiben das Optikmodul
Series-7-GTX endet bei 10,3125 Gb/s, passend zu SFP+ 10G; UltraScale/UltraScale+ GTH/GTY laufen über 16G und unterstützen 25G. Der Transceiver übernimmt Serialisierung/Deserialisierung, 8b/10b- oder 64b/66b-Kodierung und Taktrückgewinnung; nach außen bleiben nur die Hochgeschwindigkeits-Paare und Modul-I2C-Verwaltung (DDM-Ablesung).
2. MAC und Frame-Verarbeitung
Über dem Transceiver sitzt das 10G/25G-Ethernet-MAC: Frame-Begrenzung, CRC-Prüfung, PAUSE-Flusssteuerung. Rx verwirft CRC-fehlende Frames und filtert nach Ziel-MAC; Tx kapselt Frames und füllt Lücken. Diese Schicht ist eine deterministische Pipeline, für volle Hardware geeignet.
3. UDP-Offload-Engine
CPU-gestütztes IP/UDP-Packetizing je Frame wird bei 10G zum Engpass. On-Chip-Offload: Hardware füllt Quell-/Ziel-IP, Ports und Checksumme; der Anwender schreibt nur Nutzlast in den DMA-Puffer, die Engine setzt Eth/IP/UDP-Köpfe auf, rechnet Checksumme und fragmentiert nach MTU. Die CPU packetisiert nicht, konfiguriert die Adresstabelle nur einmal beim Start — das ist Stack-Offload.
4. Fehlerstatistik und Link-Überwachung
On-Chip-Zähler erfassen CRC-Fehler, verworfene Frames und FEC-Korrekturen und melden sie periodisch über den Management-Kanal; zusätzlich werden Tx-Leistung, Rx-Optikleistung und Temperatur des Moduls (DDM) gesammelt, um bei fallender Marge früh zu warnen, statt auf ein defektes Bild zu warten.
4. Praxisbeispiel: Mehrknoten-Erfassung über 10G-Faser zurückgeführt
Ein verteiltes Erfassungssystem hat 4 entfernte Knoten; jeder führt zwei SDR-ZF-Kanäle und einen Videokanal zusammen, ~2,2 Gb/s effektiven Backhaul; die Zentrale aggregiert über eine 10G-Faser, mit Jumbo Frame ~9,9 Gb/s Nutzlast, 4 Knoten zu 8,8 Gb/s mit Reserve. Alle Protokolle laufen als UDP-Offload im FPGA, der Host erhält nur Nutzlast.
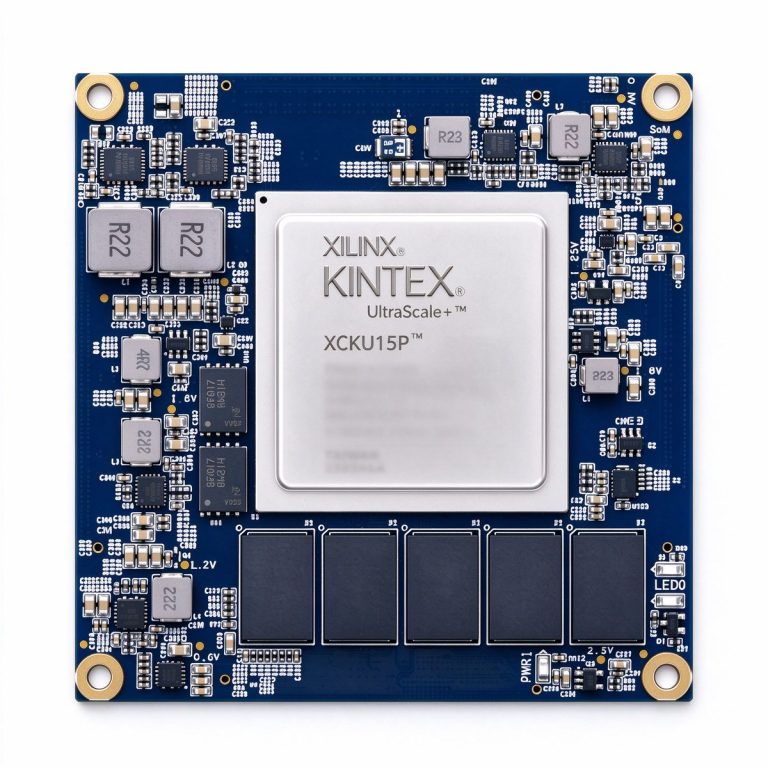
- Hochbandbreite (XCKU15P / Kintex UltraScale+): großzügige GTY-Transceiver-Marge für 25G oder mehrere 10G-Spuren, für einen Haupt-Aggregationsknoten mit Ausbau auf 25G/100G.
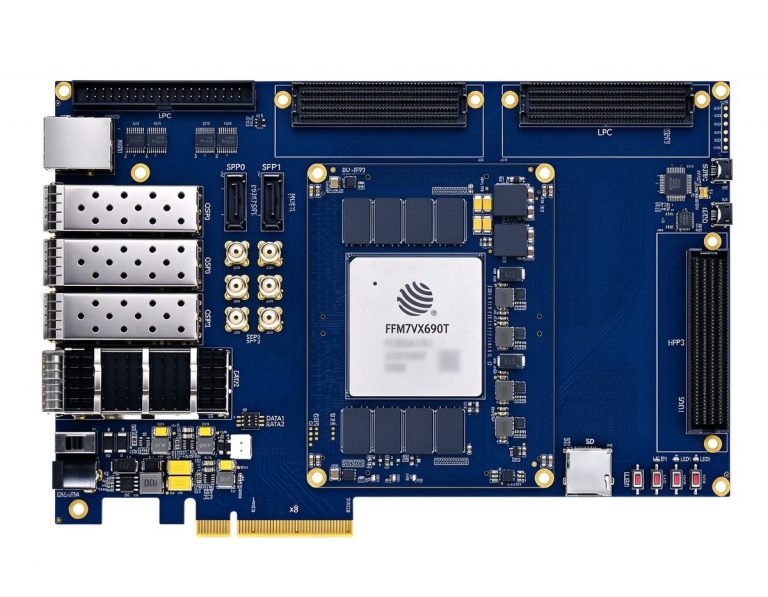
- Kapazitäts-Aggregation (DUF7690T / JFM7VX690T): viel Logik und On-Chip-RAM für mehrere MACs, UDP-Offload-Engines und große Queues, für zentrale Mehrknoten-Aggregation und Linienraten-Weiterleitung.
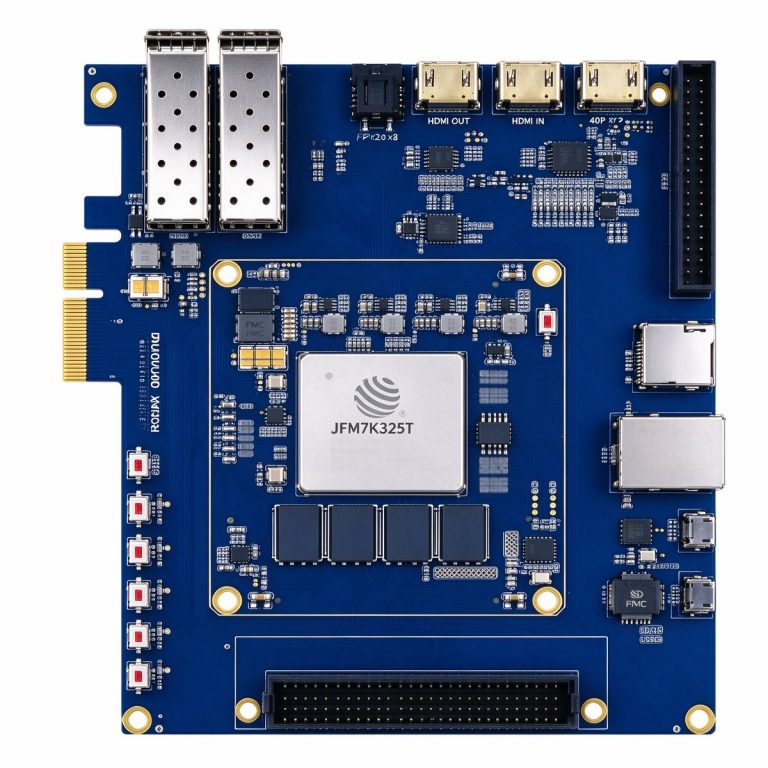
- 10G-Proto-Einstieg (DUK7325T / JFM7K325T): Series-7-GTX sättigt 10G-Linienrate mit ausgewogenen Kosten, für Einzelknoten-10G-Prototyp und Einstiegsprodukte.
Faser-Backhaul heißt im Kern, Transceiver und Hardware-Stack des FPGA das „Senden mit Linienrate” für die CPU erledigen zu lassen. Zwei Zahlen merken: über MTU1500 liefert 10G ~9,6 Gb/s und 25G ~24 Gb/s Nutzlast. Knoten nach Nutzlast statt Nennrate bemessen, Link-Budget und BER vorab rechnen, dann fällt der Backhaul im Feld nicht ab.