Medizinischer Ultraschall-Beamforming: 128-Kanal-Signalkette und Datenraten-Budget
Eine 128-Kanal-Farbdrucksonde sampelt jeden Kanal mit einem 12-Bit-, 40 MS/s-ADC und ergibt eine Rohdatenrate von etwa 7,7 GB/s — ein Maß, das eine CPU nicht aufnehmen, geschweige denn in Echtzeit abbilden kann. Der richtige Ansatz: Beamforming, Hüllkurvendetektion und Dezimierung zuerst im FPGA ausführen und nur komprimierte Bilddaten an den Rechner übergeben. Dieser Artikel zerlegt die 128-Kanal-Kette in Stufen, budgetiert die Datenrate je Stufe und erklärt, was der FPGA dazwischen übernimmt.
1. Die vollständige Ultraschall-Signalkette
Vom Sondenarray zum Graustufenbild auf dem Bildschirm durchläuft das Signal eine lange Kette; der FPGA sitzt nach dem analogen Frontend und vor der Host-Bildgebung:
1. Sondenarray (128 Elemente): sendet Ultraschall aus und empfängt Gewebe-Echos; jedes Element entspricht einem eigenen Kanal.
2. Analoges Frontend (AFE): TGC-Zeitgewinnkompensation → Bandpassfilter → variable Verstärkung → ADC-Digitalisierung.
3. FPGA-Beamforming: kanalweise programmierbare Verzögerung, Gewichtung und Summation zur Abtastzeile, dynamische Fokussierung.
4. IQ-Demodulation + Dezimierung + Hüllkurvendetektion: Hochfrequenz-RF-Signal in Amplituden-Graustufendaten komprimieren.
5. Scan-Konvertierung + Frame-Puffer + PCIe-Upload: Polare Abtastzeilen in kartesische Koordinaten umrechnen und zur DSC/Farbbildung an den Host senden.
Schritt 3 und 4 müssen deshalb im FPGA laufen: 128 Kanäle müssen in Mikrosekunden ausgerichtet, verzögert und gewichtet summiert werden, wobei jede Verzögerung sich dynamisch mit der Tiefe ändert. Das ist hochgradig parallele, kanalweise, deterministisch getaktete Arbeit; Software auf einer allgemeinen CPU fehlt es sowohl an Parallelität als auch an der Echtzeit-Bildrate.
2. 128-Kanal-Datenraten-Budget (erst rechnen, dann anschließen)
Das Budget beginnt beim Einzelkanal-ADC und multipliziert nach oben. Ein 12-Bit-, 40 MS/s-ADC:
| Stufe | Pro Kanal | 128 Kanäle gesamt | Hinweis |
|---|---|---|---|
| ADC-Rohabtastung | 12 Bit × 40 MS/s = 480 Mb/s (60 MB/s) | 128 × 480 = 61440 Mb/s ≈ 61,4 Gb/s (7,68 GB/s) | Rohpeak am FPGA-Eingang |
| Beamforming (verzögerte Summe) | 128 Kanäle gewichtet summiert → 1 Zeile | Nach der Summe keine 128 Parallelpfade mehr | Parallelität wird hier komprimiert |
| IQ-Demod + CIC/FIR-Dezimierung | RF 40 MS/s → ~10 MS/s komplex | Einzelpfad ~20 MB/s (komplex 12-Bit) | Nach Dezimation unter 1/4 der Rohrate |
| Hüllkurvendetektion + Log-Kompression | 8-Bit-Amplitude, ~10 MS/s | Einzelpfad ~10 MB/s | Dynamik auf 40–60 dB komprimiert |
| PCIe-Upload zum Host | — | 256 Zeilen × 60 fps × 8 Bit ≈ 122 MB/s | CPU bearbeitet nur diese Stufe |
Kernschluss: Die Kompression findet im FPGA statt. In den FPGA fließt ein 61,4 Gb/s-starker Roh-Parallelstrom; heraus zum Host kommen nur etwa 122 MB/s Graustufen-Frame-Daten. Das Kompressionsverhältnis übersteigt das 60-fache — erreicht dadurch, dass Beamforming 128 Pfade zu einem zusammenführt und Dezimierung/Detektion Hochfrequenz-RF zur Amplitudenhüllkurve kollabiert. Den FPGA zu überspringen und den 7,68 GB/s-Rohstrom auf eine CPU zu schieben, verkraftet weder Speicherbandbreite noch PCIe.
Bildrate und Anzahl der Abtastzeilen
Beim Beamforming erfordert jede Zeile eine frische 128-Kanal-verzögerte Summe. Hat ein Frame N Zeilen bei Rate F, muss der FPGA pro Sekunde N×F Summen bilden. Bei N=256 und F=60 fps sind das 256 × 60 = 15360 Abtastzeilen pro Sekunde, jede summiert 128 gewichtete, verzögerte Samples — der Ausgangspunkt für die Bemessung von FPGA-Multiplikatoren (DSP) und On-Chip-RAM (Verzögerungslinien-FIFOs).
3. Wie die FPGA-interne Kette aufgeteilt wird
1. Synchronisierte Erfassung und Kanalausrichtung
Die 128 Kanäle erstrecken sich meist über mehrere AFEs und gelangen per JESD204B oder parallelem LVDS in den FPGA. Erste Hürde ist die Skew-Kompensation: Die Leiterbahnen sind je Kanal unterschiedlich lang, daher müssen die Samples vor dem FIFO auf einen Taktbezug ausgerichtet werden; sonst phasenverschobene Summation erzeugt Nebenkeulen und Geisterartefakte.
2. Dynamisch fokussierte verzögerte Summe (Delayed-and-Sum)
Jedes Element sitzt in anderer Entfernung zum Fokuspunkt, Echos kommen zu unterschiedlichen Zeiten. Der FPGA kompensiert diese Zeitdifferenz kanalweise mit programmierbaren Verzögerungslinien (tiefenverstellbare FIFOs oder getappte Verzögerungen), multipliziert mit Apodisierungsgewicht und summiert. Die Fokustiefe bewegt sich mit dem Zeitfenster, daher werden Verzögerungsparameter je Segment aktualisiert; das verbraucht viel On-Chip-BRAM und DSP für Multiplizieren-Akkumulieren.
3. IQ-Demodulation, Dezimierung und Hüllkurvendetektion
Die summierte RF-Zeile durchläuft zuerst die Quadraturdemodulation (I/Q-Mischung), dann dezimiert eine CIC + FIR-Kaskade die Abtastrate; eine Hilbert-Transformation gewinnt die Hüllkurve, Log-Kompression bildet die große Dynamik auf 8-Bit-Graustufen ab. Diese Stufe ist typische Pipeline-Filterung — hohe DSP-Auslastung, aber geringe Parallelität.
4. Scan-Konvertierung, Frame-Puffer und Upload
Polare fächerförmige Zeilen werden zu kartesischen Rechteckpixeln resampled, in einen DDR3/4-Frame-Puffer geschrieben, dann sendet DMA den kompletten Frame per PCIe zum Host. Diese Stufe kümmert sich um DDR-Lese-/Schreibbandbreite und die DMA-Engine, nicht um DSP-Durchsatz.
4. Praxisbeispiel: Auslegung eines tragbaren Farbdruck-Frontends
Ein tragbares Farbdruck-Frontend nutzt ein 128-Kanal-AFE mit RF-Abtastung 40 MS/s, 12-Bit. Beamforming muss 128 Verzögerungslinien und gewichtete Multiplikationen parallel bearbeiten, plus einen Blutfluss-Doppler-Kanal. Nach obigem Budget komprimiert sich das Rohsignal 61,4 Gb/s im FPGA auf etwa 122 MB/s Graustufen-Frames; PCIe Gen2 x4-Nettbandbreite trägt dies komfortabel.
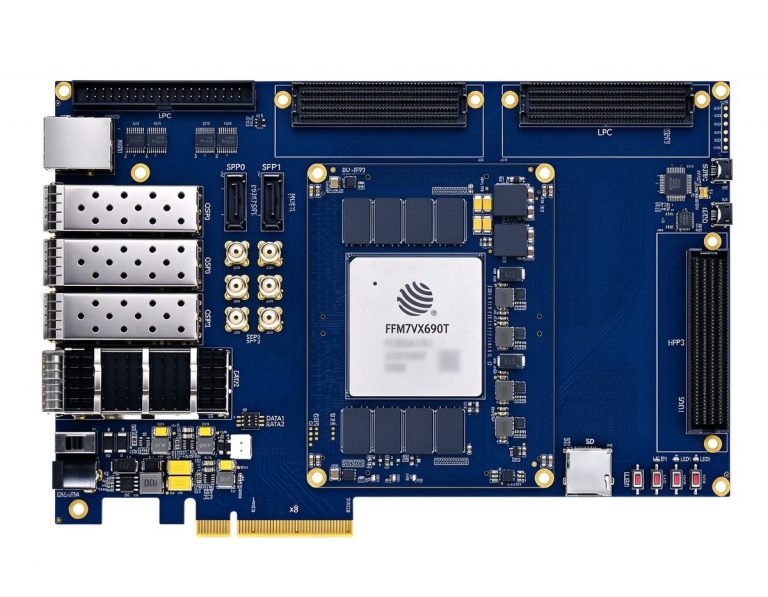
- Großkapazität (DUF7690T / JFM7VX690T): reichlich Logik und On-Chip-RAM, um 128 Verzögerungslinien-FIFOs, Graustufensynthese und Doppler-Kanal zugleich zu halten; geeignet für volle 128 Kanäle bei hoher Bildrate.
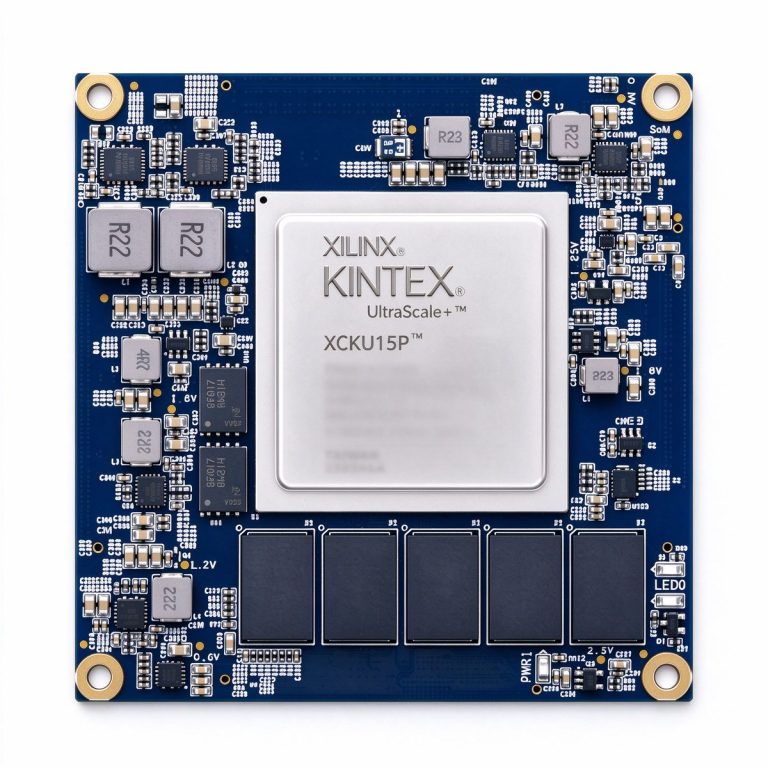
- Kanalerweiterung (XCKU15P): starke Transceiver und Mehrkanal-LVDS-Aggregation; geeignet für weitere Kanalerweiterung oder verteilte Sonden, die AFE-Daten per Fiber zurücksenden.
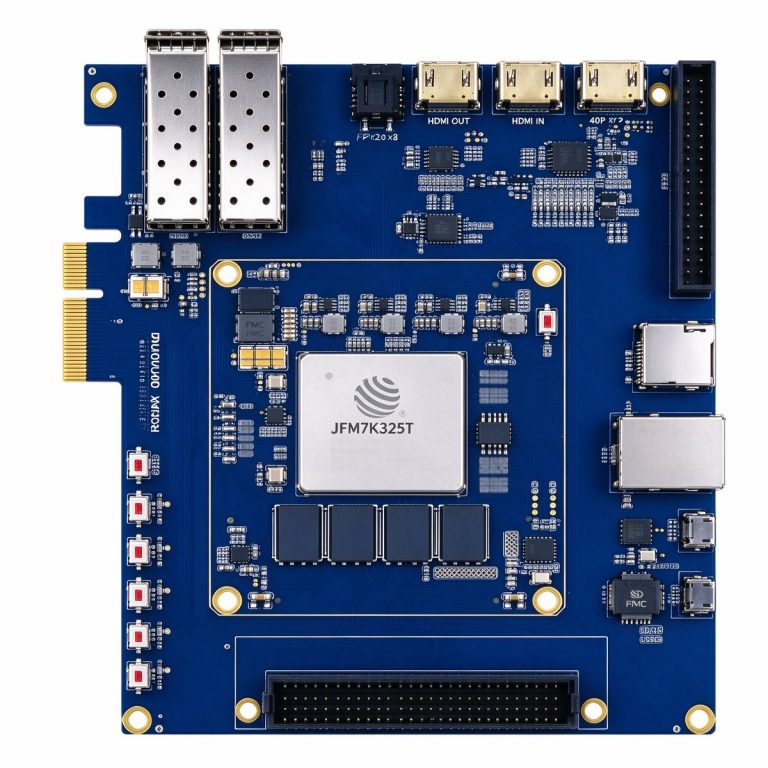
- Mittelklasse-Einstieg (DUK7325T / JFM7K325T): ausgewogene Ressourcen und Kosten; geeignet für 64–128-Kanal-Graustufen-Prototyping und Mittel-/Niedrigprodukte — Verzögerte Summe und Detektion hier durchlaufen, bevor eine Großkapazitätsplattform gewählt wird.
Ultraschallbildgebung ist im Kern: 128 Hochgeschwindigkeits-Roh-Echos per paralleler verzögerter Summe im FPGA zu einer Abtastzeile zu “rechnen”. Ist das Datenraten-Budget klar — 61,4 Gb/s Frontend, 122 MB/s Upload — weiß man, welcher Schritt on-chip bleiben muss und welcher zum Host kann. In medizinischem Ultraschall ist der FPGA keine Beschleunigungskarte; er ist die Bildgebung selbst.