Migration in die chinesische FPGA-Toolchain PDS: Die konkreten Schritte von Vivado zu Pango/FudanMicro
Viele gehen davon aus, dass die lokale Migration vor allem ein Chip-Tausch ist. Die erste Hürde ist aber tatsächlich die Toolchain. Der Wechsel von Vivado zu Pango PDS oder zu der EDA von FudanMicro verändert, wie man ein Projekt öffnet, Constraints schreibt, IP instanziiert und Timing schließt. Dieser Artikel zerlegt die Migration Schritt für Schritt — was sich in jedem Schritt ändert, welche Fallstricke wir erlebt haben und wie viel Aufwand typischerweise nötig ist.
Zuerst klarmachen: Pango und FudanMicro sind nicht derselbe Migrationspfad
Beim Wechsel von Vivado zu einer lokalen Toolchain nehmen viele an, es sei „nur eine andere EDA”. In Wirklichkeit unterscheiden sich Pango und FudanMicro stark. Klären Sie zuerst, welche Linie vor Ihnen liegt:
| Zielchip | Toolchain | Öffnen des Projekts | Migrationsschwierigkeit |
|---|---|---|---|
| Pango Titan3 / Kosmo-2 | Pango Design Suite (PDS) | Projektstruktur, IP-Bibliothek und Constraint-Syntax weichen alle von Vivado ab | Mittel, Ablauf ähnlich Vivado, aber Projekt muss neu aufgebaut werden |
| FudanMicro JFM7-Serie | FudanMicro-EDA | 7-Serie-kompatible Bausteine, ähnliche Projektstruktur | Mittel-niedrig, IP-Bibliothek muss neu zugeordnet werden |
Pango verfolgt die Route „neue Architektur + eigene PDS”, ein Vivado-Projekt muss daher im Wesentlichen neu aufgebaut werden; FudanMicro verfolgt die Route „7-Serie-kompatibel + ähnlicher Ablauf”, sodass mehr vom Projekt wiederverwendet werden kann. Die Schritte unten gelten allgemein für beide.
Schritt eins: Das Vivado-Projekt aufteilen, nicht komplett verschieben
Die Vivado-Projektdatei `.xpr` öffnet sich in einer lokalen Toolchain nicht. Richtig ist, das Projekt in wiederverwendbare Teile zu zerlegen:
1. RTL-Quellcode: `.v` / `.vhd`-Dateien sind reiner Text und direkt wiederverwendbar, keine Änderung nötig (sofern keine Xilinx-eigenen Primitiven genutzt werden).
2. Constraints: Der Großteil der `.xdc`-Syntax ist lesbar, aber Pin-Zuordnung und Taktdefinitionen müssen für den neuen Baustein neu geschrieben werden.
3. IP-Kerne: Xilinx-FIFO/BRAM/PCIe/DDR-IP können nicht direkt genutzt werden; stattdessen das entsprechende IP des lokalen Herstellers instanziieren.
4. Simulation und Test: Die `tb`-Testbench ist wiederverwendbar, aber die für die Simulation genutzten IP-Bibliothekspfade müssen geändert werden.
Der damit verbundene Aufwand
Ein FPGA-Team von 3–5 Personen braucht typischerweise 3–5 Arbeitstage zum Aufteilen des Projekts und zum Wiederaufbau des Skeletts in der lokalen Toolchain. Die eigentliche Kostenlast liegt nicht hier, sondern in den Constraints und dem IP unten.
Schritt zwei: Die Constraint-Datei ist die erste Stolperfalle
Die `.xdc`-Syntax ist Vivado sehr ähnlich, aber die Details unterscheiden sich und verursachen die meisten Fallstricke:
- Pin-Zuordnung: Das BGA-Ball-Map unterscheidet sich, daher muss `set_property PACKAGE_PIN` gegen den neuen Baustein neu durchgeführt werden. Pango nutzt das `PACE`-Pin-Tool in PDS, FudanMicro einen ähnlichen Ablauf.
- Takt-Constraints: `create_clock` / `create_generated_clock`-Syntax ist kompatibel, aber die Ressourcennamen der Taktquelle (Quarz, MMCM/PLL) müssen geändert werden.
- IO-Standards: LVDS, LVCMOS und Bank-Spannungen werden gegen das Datenblatt des neuen Bausteins neu eingestellt.
Praxistipp: Machen Sie zuerst eine Pin-Zuordnung in PDS mit `PACE` oder im FudanMicro-Pin-Tool, dann exportieren Sie die Constraints. Das ist weit zuverlässiger als das Handschreiben von `.xdc` und spart mehrere Korrekturrunden.
Schritt drei: IP-Neuinstanziierung (Kostenkern)
Dies ist der größte Teil der Migrationskosten. Der Aufwand variiert stark nach IP-Typ:
| IP-Typ | Vivado-nativ | Lokale Alternative | Aufwand |
|---|---|---|---|
| DDR-Controller | MIG (DDR3/DDR4) | Lokaler DDR-PHY + Controller | Hoch: Timing, Kalibrierung, Trainingsablauf unterschiedlich |
| PCIe-Hardcore | Integrated Block for PCIe | Lokaler PCIe-PHY + Enumeration | Mittel: Parameter neu abstimmen, Logik wiederverwendbar |
| Highspeed-Transceiver | GTX / GTH / HSST | Lokaler Transceiver-PHY | Hoch: Referenzuhr, Pre-Emphasis, Equalization neu abstimmen |
| FIFO / BRAM / DSP | Generator-IP | IP des lokalen Herstellers | Niedrig: neu generieren, Logik wiederverwendbar |
| PLL / MMCM | Clocking Wizard | Lokales Takt-IP | Niedrig: Parameter neu eintragen |
Jedes Highspeed-Schnittstellen-IP (DDR, PCIe, SerDes) ist nicht „nur Parameter ändern” — es betrifft die Signalintegrität auf der Platine. Das PCB wurde nach dem Xilinx-Referenzdesign verlegt; nach dem Wechsel auf einen lokalen PHY müssen Augendiagramm neu gemessen, Equalization neu abgestimmt und das Link-Training neu ausgeführt werden. Das ist meist der am wenigsten beherrschbare Teil einer Migration, also planen Sie mindestens 2–4 Wochen ein.
Schritt vier: Timing-Closure und Iteration
Lokale FPGAs lassen bei gleicher Klasse meist weniger Timing-Reserve als Xilinx; ein 100-MHz-Design mit 20 % Reserve kann nach der Migration nur noch 5–10 % haben. Das ist zu tun:
1. In der lokalen Toolchain neu synthetisieren und Place-and-Route ausführen und den Timing-Report lesen (PDS `Report Timing` / das FudanMicro-Pendant).
2. Kritische Pfade lokalisieren, RTL optimieren oder Pipeline-Stufen ergänzen.
3. Synthese iterieren, bis das Timing schließt.
Das dauert meist 1–2 Wochen, je nach Designkomplexität und ursprünglicher Timing-Reserve.
Umsetzungs-Checkliste und typischer Zeitplan
Eine „Vivado → lokale Toolchain”-Migration, die die vier Schritte oben verbindet, sieht typischerweise so aus:
| Schritt | Inhalt | Typische Dauer |
|---|---|---|
| Projekt aufteilen | RTL wiederverwenden, Skelett neu aufbauen | 3–5 Tage |
| Constraints neu schreiben | Pins/Takte/IO-Standards neu zuordnen | 3–5 Tage |
| IP neu instanziieren | DDR/PCIe/Transceiver dominieren | 2–4 Wochen |
| Timing-Closure | Synthese + Routing + Iteration | 1–2 Wochen |
| Board-Verifikation | Inbetriebnahme, Augendiagramm, Link-Regression | 2–4 Wochen |
Ein Projekt mittlerer Komplexität summiert sich auf etwa 1–2 Monate, wobei die Kostenlast bei IP-Neuinstanziierung und Timing-Closure liegt.
Auswahlhinweis: Wie baut man das lokale Board-Set
Bei der Auswahl eines Boards für eine Migration sollte man zuerst klären, auf welcher Chiplinie das Ziel liegt, dann das passende Board wählen:
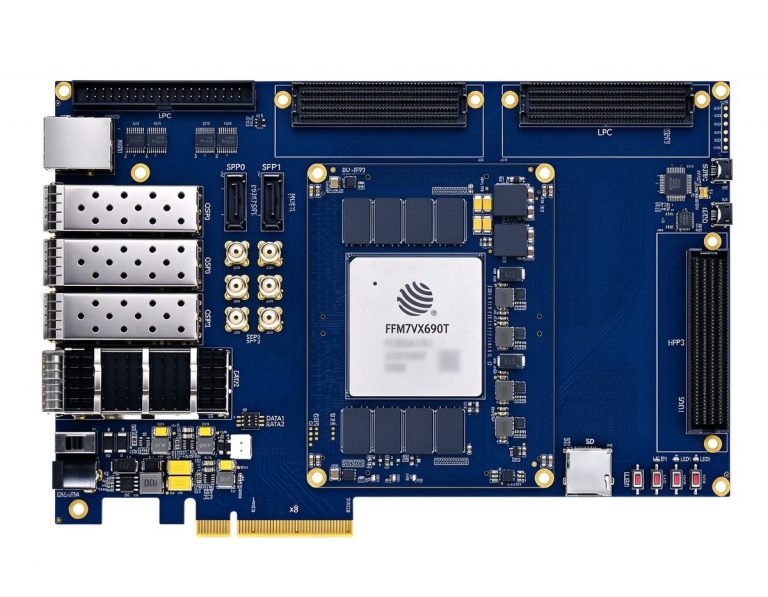
- FudanMicro JFM7VX690T (DUF7690T): Virtex-7-Klasse, 7-Serie-pin-kompatibles Gehäuse, für die Pin-to-Pin-Migration von der Xilinx-7-Serie, Industrietemperatur.
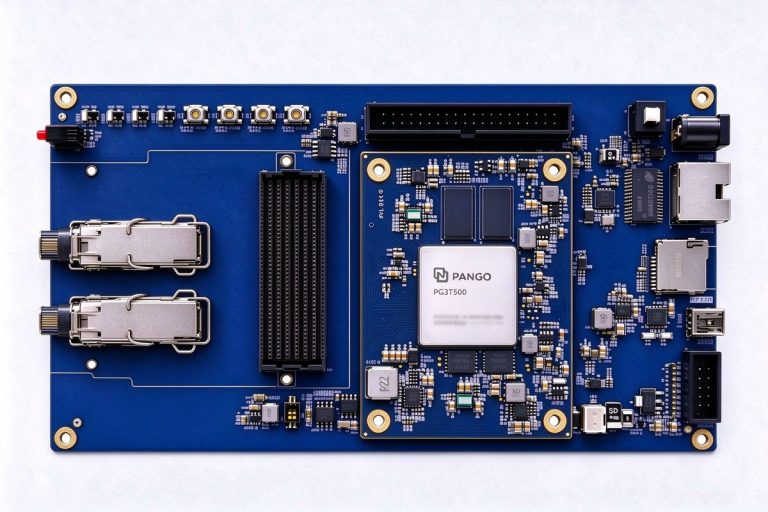
- Pango Titan3 (PG3T500): High-End-Plattform mit neuer Architektur, für Designs, die große Ressourcen brauchen und den PDS-Ablauf nutzen.
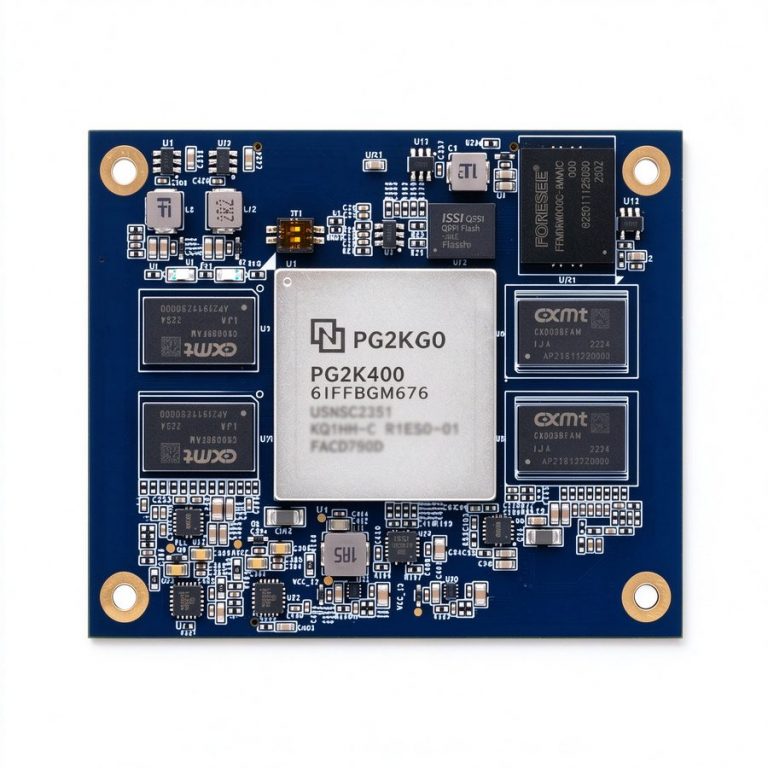
- Pango Kosmo-2 (PG2K400): ARM + FPGA heterogen, für ZYNQ/MPSoC-artige Designs, die zu einem lokalen SoC wechseln.
Die eigentliche Hürde bei einer lokalen Toolchain-Migration ist nicht, ob sich das RTL verschieben lässt, sondern dass Constraints, IP und Timing neu durchlaufen werden müssen. Projekt zuerst aufteilen, Constraints neu schreiben, den Aufwand auf IP und Timing-Closure konzentrieren und den Zeitplan und das Budget um „1–2 Monate, IP ist der größte Posten” planen — dann kommt die Migration nach Plan und scheitert nicht auf halbem Weg.
Weiterlesen
- [Die realen Kosten der lokalen Migration: ein TCO-Rahmen](/article/china-fpga-migration-tco-cost-framework/)
- [Lokaler ZYNQ-Ersatz in der Praxis: von XC7Z020 zu PBC7Z020G/021G](/article/zynq-china-replacement-pbc7z020-practical/)
- [Wie wählt man einen FPGA: eine Entscheidungsmatrix aus Ressourcen, Transceivern und Preis](/article/fpga-selection-decision-matrix/)