TSN: Wie deterministisches Ethernet und Frame-Preemption auf dem FPGA wirklich landen
Das „Best Effort” des Standard-Ethernet reicht in der Industriesteuerung nicht: eine große Dateiübertragung am selben Kabel kann einen Motion-Control-Frame um Millisekunden verzögern. TSN (Time-Sensitive Networking, IEEE 802.1) legt mit Zeitsynchronisation, zeitgesteuerter Verkehrslenkung und Frame-Preemption aus Ethernet ein vorhersehbares, berechenbares Netz. Dieser Artikel rechnet es in Zahlen herunter und zeigt die Umsetzung auf FPGA-Boards.
Warum Standard-Ethernet in der Industriesteuerung „unvorhersehbar” ist
Standard-Ethernet heißt im Wesentlichen: wer zuerst kommt, sendet zuerst. Das Problem ist nicht die mittlere Latenz, sondern der unkontrollierbare Worst Case:
- An einem 1Gbps-Port wird gerade ein 1518-Byte-Rahmen übertragen;
- Im selben Moment trifft ein 64-Byte-Hochprioritäts-Motion-Control-Frame am Switch-Port ein;
- Der Switch kann den laufenden Rahmen nicht unterbrechen, also muss der Control-Frame warten.
Diese Warteschlange ist die Quelle des Jitters. Im Büronetz ist das egal; bei Mehrachs-Bewegungssteuerung, Robotergelenken und Servo-Koordination beträgt der Steuerzyklus aber typisch 125µs oder weniger – ein um wenige hundert Mikrosekunden verspäteter Steuerrahmen lässt die Achsen auseinanderlaufen.
TSN ändert nicht das Kabel, sondern legt auf Ethernet deterministische Planungsregeln auf, sodass der Worst Case entwerfbar und berechenbar wird.
Was TSN wirklich löst: vier Standards zusammen
TSN ist kein einzelnes Protokoll, sondern eine Standardsammlung der IEEE-802.1-Arbeitsgruppe. Die vier häufigsten Bausteine:
| Standard | Was er löst | Einfach erklärt |
|---|---|---|
| 802.1AS (gPTP) | Netzweite Zeitsynchronisation | Alle Switches und Knoten teilen eine Uhr, innerhalb 1µs |
| 802.1Qbv (TAS, Time-Aware Shaper) | Verkehr nach Fahrplan senden | Jeder Port hat einen „Gate-Fahrplan”: wann Echtzeit-, wann Normalverkehr rausgeht, mikrogengenau |
| 802.1Qbu / 802.3br (Frame-Preemption) | Hochprioritätsrahmen nicht durch große Rahmen blockiert | Ein langer Rahmen lässt sich mittendrin unterbrechen, vortreten lassen und fortsetzen |
| 802.1Qat / 802.1Qav | Bandbreitenreserve und Queue-Management | Echtzeitströmen wird feste Bandbreite reserviert, Normalverkehr kann nicht hineinplatzen |
Stell dir TSN wie eine Busspur auf dem Kabel vor: zuerst synchronisieren alle Kreuzungen ihre Uhren (gPTP), dann muss der Bus zur geplanten Zeit die Sonder spur nutzen, andere Verkehr zur Nebenzeit (TAS), und wenn ein LKW blockiert, schiebt sich der Bus durch eine Lücke (Preemption).
Drei Zahlen: Latenz von Millisekunden auf Mikrosekunden
Wie lange ein Rahmen ein 1Gbps-Kabel belegt
Zuerst die physikalische Ebene. 1Gbps = 10^9 Bit pro Sekunde; Sendezeit = Bit / 10^9.
| Rahmengröße | Bytes | Bits | Sendezeit bei 1Gbps |
|---|---|---|---|
| Minimaler Ethernet-Rahmen | 64 B | 512 Bit | 0,512 µs |
| Normaler Rahmen | 512 B | 4096 Bit | 4,10 µs |
| Standard-Maximalrahmen | 1518 B | 12144 Bit | 12,14 µs |
| Jumbo-Rahmen | 9000 B | 72000 Bit | 72,0 µs |
Ein Standard-Maximalrahmen belegt die Leitung also rund 12,1µs. Ohne Preemption wartet ein Hochprioritäts-Control-Rahmen schlimmstenfalls diese vollen 12,1µs – plus Switch-Weiterleitung und Queue, womit der Jitter leicht in Hunderte Mikrosekunden bis Millisekunden geht.
Wie viel Blockierung Preemption nimmt
802.1Qbu/802.3br teilt einen langen Rahmen an einer 64-Byte-Grenze. Wenn ein Hochprioritätsrahmen eintrifft:
- Hat der laufende lange Rahmen die ersten 64 Byte passiert (Fragment-Checkpoint), sofort unterbrechen;
- Den Hochprioritätsrahmen vollständig senden (schlimmstenfalls 0,512µs);
- Die Bruchstelle am langen Rahmen merken und später fortsetzen.
Vergleich der Worst-Case-Blockierung:
- Ohne Preemption: Control-Rahmen wartet einen ganzen großen Rahmen ≈ 12,14µs;
- Mit Preemption: Control-Rahmen wartet weniger als ein Fragment (≤64B, 0,512µs) plus eigene Sendezeit.
Diese Lücke von ~12µs auf ~1µs ist der Grund, warum TSN Mikrosekunden-Steuerzyklen erreicht.
Wie gPTP die Zeit ausrichtet
Der TAS-Fahrplan muss netzweit eine gemeinsame Uhr nutzen, sonst öffnet jeder Switch seine Tore zu anderer Zeit. 802.1AS (gPTP) richtet Master und Slave über Link-Layer-Zeitstempel ab:
- Der Grandmaster sendet periodische Sync-Telegramme;
- Jeder Switch-Hopf timestempelt Paket-Ein/Aus in Hardware, um die Asymmetrie der Verbindung zu korrigieren;
- Endknoten stellen ihre lokale Uhr nach dem Grandmaster.
Praktisch liegt der gPTP-End-zu-End-Offset typisch innerhalb ±1µs – Voraussetzung dafür, dass TAS-Fahrpläne auf Mikrosekunden genau geplant werden können. Ohne gute Synchronisation ist die ganze Planung nutzlos.
TSN auf dem FPGA: von MAC bis Zeit-Gating
TSN-Zeitstempel und -Gating brauchen Hardware-Präzision; ein CPU-plus-Software-Stack schafft keine Mikrosekunden – genau hier sitzt der FPGA. Eine typische FPGA-TSN-Knotenkette:
1. PHY: multi-rate 100M/1G/2,5G/5G, mit Fragmentierung und Wiederzusammensetzung für Frame-Preemption (802.3br);
2. Ethernet-MAC: harte oder weiche MAC, die getimte Ströme ausgibt;
3. TSN-IP-Kern: gPTP-Slave-Uhr, TAS-Zeitgate-Scheduler, Preemption/Rekombination in FPGA-Logik;
4. Anwendungslogik: Motion-Control-Frames, Sensordaten und Normalverkehr in getrennten Queues.
Der entscheidende Punkt: Zeitstempel müssen in Hardware an der PHY/MAC-Grenze gesetzt werden, nicht von der Software nach dem Empfang – Letzteres allein kostet schon Dutzende Mikrosekunden. Der FPGA hält „Paket kommt an → timestempeln → Gate-Tabelle prüfen → Sendezeit entscheiden” in einer einzigen Taktdomäne.
Auswahl: drei Board-Klassen für TSN-Knoten
Unterschiedliche TSN-Szenarien brauchen unterschiedliche Logikressourcen und Transceiver; Auswahl nach Budget und Portzahl:
| Board | FPGA-Plattform | TSN-Rolle | Warum |
|---|---|---|---|
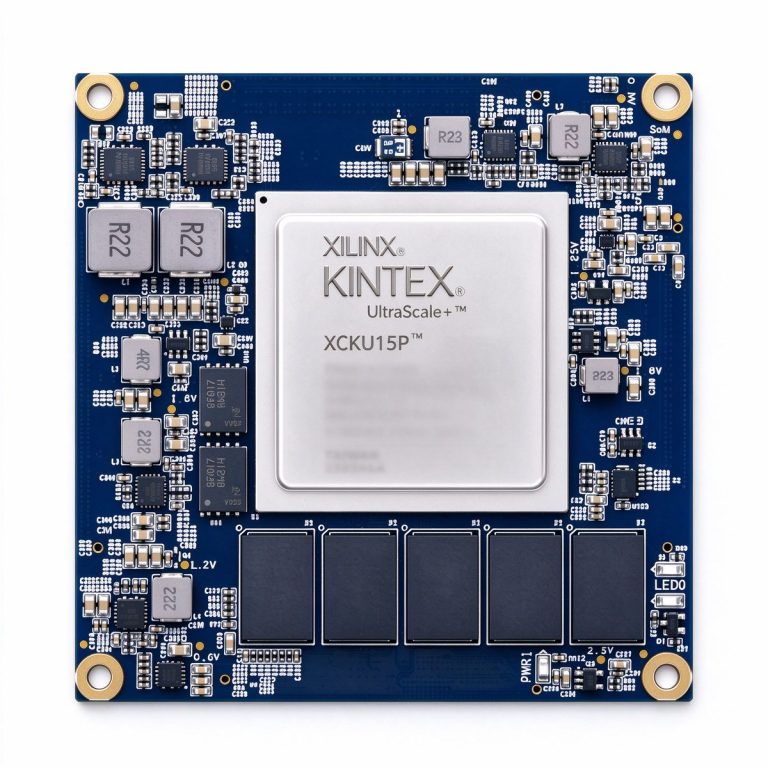
| XCKU15P-Core-Board | Kintex UltraScale+ | Mehrport-TSN-Aggregation / Edge-Gateway | Viel Logik, GTH-Transceiver und harte Tri-Mode-MAC; fährt gPTP-Slave + mehrfaches TAS-Scheduling + Beschleunigung zusammen |
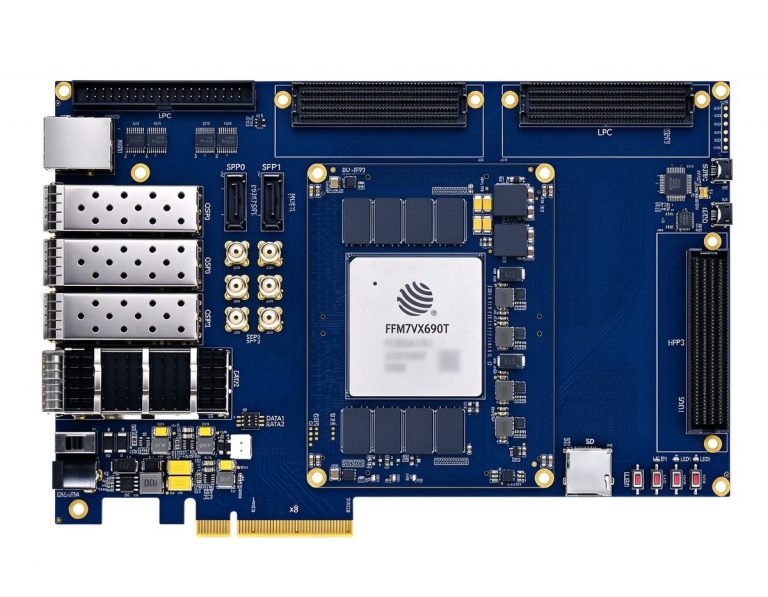
| DUF7690T | FudanMicro JFM7VX690T (kompatibel zu XC7VX690T) | Hochzuverlässiger / inländischer TSN-Knoten | Virtex-7-Klasse, Industrietemperatur, für Lieferketten- und zuverlässigkeitskritische Linien |
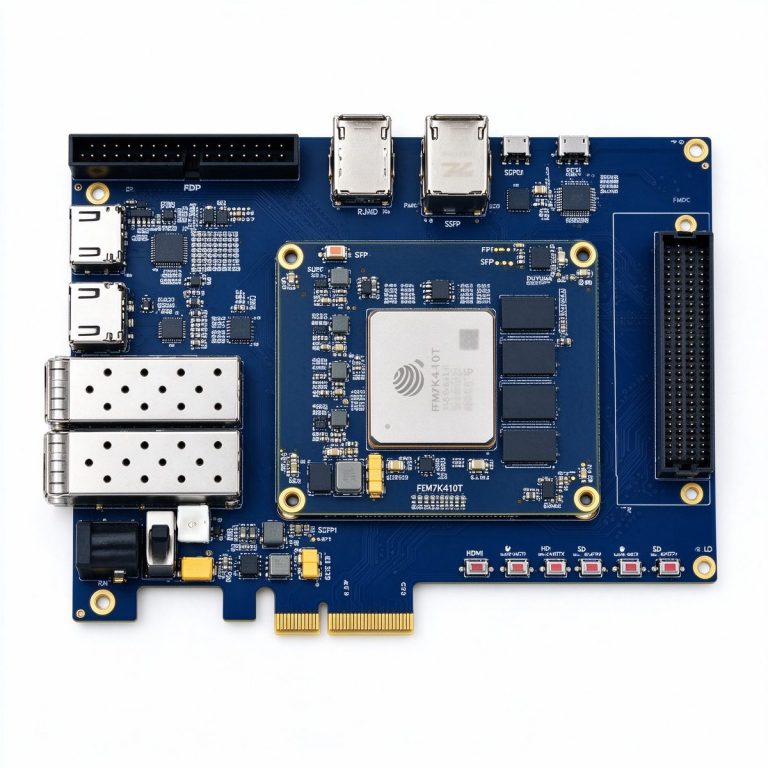
| DUK7410T | FudanMicro JFM7K410T (kompatibel zu XC7K410T) | Ein-/zweiportiges TSN-Endgerät | Kintex-7-Klasse, günstiger; reicht für einen gPTP-Slave-Port plus einfaches TAS, gut für Massen-Endknoten |
Eine übliche Mischung: DUK7410T als Feld-Endknoten, DUF7690T als inländische Arbeitsplatz-Gateways, XCKU15P als Mehrport-TSN-Aggregationsknoten der ganzen Linie – so werden normaler IP/Vedio-Verkehr und Echtzeit-Steuerungsverkehr auf einem Kabel durch TSN-Queues getrennt.
Anwendungsbeispiel: ein Mischkabel auf TSN umstellen
Eine Maschine nutzte ursprünglich zwei Kabel: eines für PLC- und Servo-Echtzeitsteuerung, eines für Kamerabilder und Logs. Nach dem Umbau auf ein Gigabit-Kabel, aufgeteilt durch TSN:
- Echtzeit-Control-Frames nutzen ein dediziertes TAS-Gate, 125µs-Zyklus, rund 10% Bandbreite reserviert;
- Kamera-Bulk-Verkehr läuft über die normale Queue, Preemption sorgt dafür, dass er den Control-Rahmen nie blockiert;
- gPTP richtet die 4 Servo-Knoten innerhalb 1µs aus.
Nach dem Umbau gemessen: der schlimmste Jitter des Control-Rahmens sank von etwa 800µs auf unter 3µs, die Kabel halbierten sich von zwei auf eines, Switch-Ports und Verkabelungskosten sanken mit.
Determinismus heißt nicht, das Netz schneller zu machen, sondern den „Worst Case” vom Unwissbaren zum Berechenbaren zu machen – genau hier legt der FPGA Zeit in Hardware.
Weiterlesen
- [10G/25G-Glasrückleitung: Hochbandbreitengrecken über Distanz](/article/fiber-backhaul-10g-25g/)
- [FMC-Mezzanin-Ökosystem: Boards um spezielle Schnittstellen erweitern](/article/fmc-mezzanine-ecosystem/)
- [PCIe-Bandbreitenplanung: Bandbreite zwischen Host und Board berechnen](/article/pcie-bandwidth-planning/)