Mehrkamera-Array auf dem Board: Echtzeit-KI-Inferenz mit FPGA/MPSoC am Rand
Wenn vier Kameras einer Linie komplett an einen Zentralserver zurückgespielt werden, reicht die Bandbreite nicht und die Latenz lässt sich nicht drücken. Besser: Erfassung, Vorverarbeitung und Inferenz laufen auf dem Board, zurückgehen nur Ergebnisse und eine komprimierte Vorschau. Dieser Artikel teilt die Edge-Board-KI-Architektur in PS/PL-Rollen auf, mit Bandbreitenbudget und Modellentwicklungsweg.
1. Warum KI-Inferenz aufs Board gehört
Das alte zentrale Vorgehen bei mehreren Kameras: jede Kamera an einen Switch, Rohestreams zum Zentralserver, ein Server-GPU läuft die Detektion über alles. Bei wenigen Kameras geht das, bei mehr Kanälen zeigen sich zwei Probleme: die unkomprimierte Rohbandbreite ist riesig, und die zentrale Inferenz bringt unvermeidliche Netzwerk-Rundwege und Warteschlangenlatenz.
Zuerst die Rohbandbreiten-Rechnung: ein einzelner 1080p30-YUV422-Stream (2 Byte/Pixel) = 1920×1080×2×30 ≈ 124 MB/s ≈ 995 Mb/s; vier Kanäle stapeln sich auf etwa 4 Gb/s unkomprimiert, vor Server-Decodierung, Queueing und Kodieraufwand. Bei diesem Maß sind Link-Kosten und Ende-zu-Ende-Latenz einer zentralen Architektur kaum zu senken.
Das Onboard-Konzept kehrt das um: Vorverarbeitung und Inferenz laufen lokal auf dem Board, nach außen gehen nur strukturierte Ergebnisse (Bounding Box, Klasse, Confidence, wenige KB pro Frame) plus eine komprimierte Vorschau; Rohpixel verlassen das Board nie.
2. Onboard-KI-Architektur: Was PS und PL jeweils übernehmen
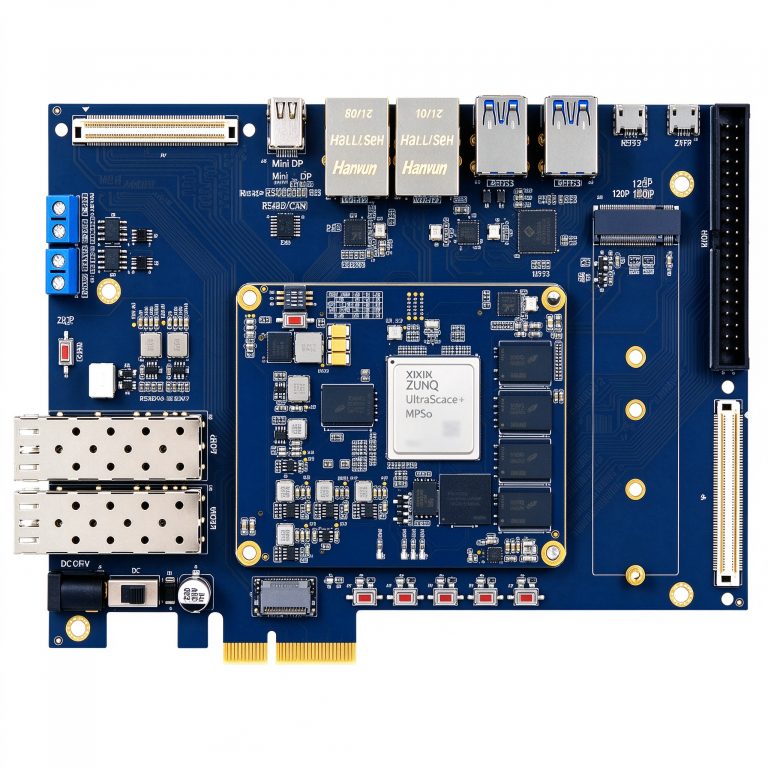
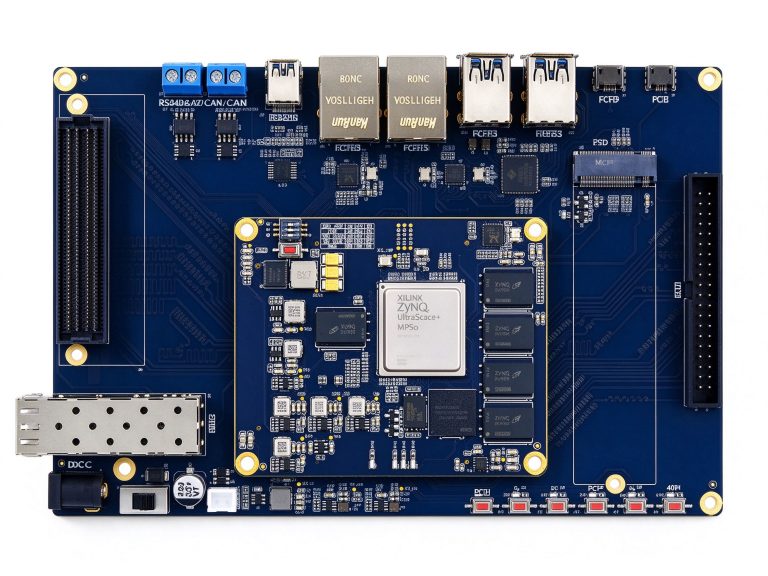
Das Zynq UltraScale+ MPSoC legt einen Quad-Core-A53-Anwendungsprozessor (PS) und programmierbare Logik (PL) in einen Chip und deckt damit „Planung plus System” und „parallele Datenpfade” ab.
1. PL: Erfassungs- und Vorverarbeitungspipeline
Kamerasignale (MIPI CSI, USB oder GigE) gelangen in die PL, wo Hardwareparallelität zuerst Entrauschen, Skalierung, Farbraumwandlung und Formatnormalisierung ausführt. Diese Operationen sind natürlich per Pixel und parallel; eine PL-Pipeline erledigt sie weit schneller als eine serielle CPU und lässt den A53 frei.
2. PL: Parallele Inferenz quantisierter Modelle
Faltung, Pooling und Aktivierung laufen in der PL als paralleles DSP-Slice-Array: Gewichte liegen im On-Chip-BlockRAM/UltraRAM oder im DDR4 der PL, Eingangs-Feature-Maps fließen durch das Multiplizier-Akkumulator-Array. Nach INT8-Quantisierung fallen Modellgröße und Speichertraffic stark. Die PL läuft kein OS; ihre deterministische Pipeline hält pro Frame einen festen Takt.
3. PS: Planung, Linux und Ergebnisrückmeldung
Der PS-Quad-Core-A53 läuft Linux für Aufgabenplanung, Host-Kommunikation und Ergebnisverpackung; der eingebaute VCU-Kodierer komprimiert gleichzeitig eine Vorschau auf H.264/H.265 und sendet sie nur bei Bedarf über das Netzwerk.
3. Bandbreitenbudget: Warum Roh-Mehrkamera nicht zurückgehen kann
| Link-Stufe | Einzelnes 1080p30 | Vier Kanäle | Hinweis |
|---|---|---|---|
| Roh unkomprimiert (YUV422) | ~995 Mb/s | ~4,0 Gb/s | Alte Vollrückspielung zum Server |
| Strukturiertes Ergebnis nach Vorverarbeitung | wenige KB/Frame | wenige KB/Frame | Box + Klasse + Confidence |
| Komprimierte Vorschau (H.264) | 2–4 Mb/s | 8–16 Mb/s | Nur bei Ansicht gesendet |
Onboard-Verarbeitung senkt die Ausgangsbandbreite von Gb/s auf Mb/s oder sogar KB/s; der Zentralserver erhält nur Ergebnisse und reserviert je Kamera kein Decoding und keine Inferenz mehr. Diese Grenze „Rohpixel bleiben auf dem Board, nur Ergebnisse gehen raus” ist der Kernvorteil des Edge-Schemas.
4. Modellentwicklung und Board-Auswahl
1. Zuerst quantisieren und beschneiden
Quantisiere das Modell auf INT8, beschneide und kürze Gewichte zur Volumenreduktion; teile dann Layer-Pipelines nach On-Chip-Speicher und DSP-Kapazität, damit nicht die gesamte Gewichtstabelle auf einmal ins Chip muss. Ein Vitis-AI-artiger Fluss kompiliert, quantisiert und deployt das Modell auf PL-Beschleunigungseinheiten, die PS-Linux hostet weiter die Anwendung.
2. Board nach Kanalzahl und Rechenleistung wählen
Edge-Vision-Board-Rollen: Einsteiger-Prototyp / Mehrkanal-Rechenleistung / reine FPGA-Parallelität
- Einsteiger-Edge-Prototyp (DUUZ4EV, Anfrage): XCZU4EV, 192K Logiczellen, 728 DSP, integrierter VCU, PS 4GB + PL 4GB DDR4; für Edge-KI-Prototypen mit ein bis zwei Kameras und schnelle PYNQ-Validierung.
- Mehrkanal-Hochrechenleistung (DUUZ5EV, Anfrage): XCZU5EV, 256K Logiczellen, 1.248 DSP, 16 GTH-Paare, FMC-LPC-Erweiterung; Plattform für mehr Kanäle und schwerere Modelle.
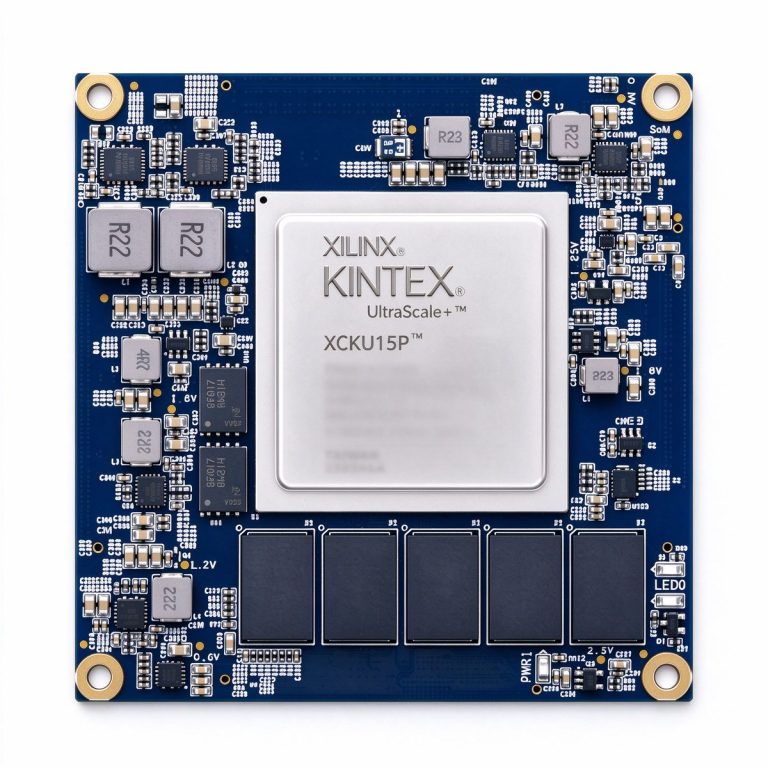
- Reine FPGA-Parallel-Erweiterung (XCKU15P, ¥15.999): Kintex-UltraScale+-Core-Board für parallele Mehrkamera-Stream-Verarbeitung und Hochgeschwindigkeitsaggregation ohne PS-System.
Edge-KI-Inferenz ist nicht das verkleinerte Server-GPU, sondern die Aufteilung der ganzen „Erfassung–Vorverarbeitung–Inferenz–Rückmeldung”-Kette auf dem Board: PL trägt parallele Pixelverarbeitung und quantisierte Faltung, PS trägt Planung und Kommunikation, der VCU komprimiert die Vorschau nebenher. Rohpixel bleiben auf dem Board, nur Ergebnisse gehen raus — Bandbreite und Latenz werden beide gelockert.