Phased-Array-Radar-Signalverarbeitung: Mehrkanal-Beamforming und Pulskompression in einer FPGA-Pipeline
Ein Phased-Array-Radar zielt elektronisch ohne bewegliche Teile. Die eigentliche Rechenlast liegt nicht in der Antenne, sondern im Backend: Jeder Empfangskanal muss gleichzeitig digitales Beamforming, Pulskompression und Zielerkennung ausführen. Dieser Artikel zerlegt diese Pipeline in berechenbare Datenraten und Ressourcenbudgets und zeigt den Aufbau auf FPGA-Boards.
Warum Phased Arrays einen FPGA brauchen
Ein klassisches mechanisch scannendes Radar blickt jeweils nur in eine Richtung, sodass das Backend nur einen Signalweg verarbeitet. Ein Phased Array hat N Antennenelemente mit je einem T/R-Modul und einem ADC. N Echo-Streams müssen gleichzeitig in den Digitalbereich, um digital Strahlen zu formen (DBF).
Das erzwingt zwei harte Randbedingungen:
- Sehr hohe Datenrate: N ADC-Kanäle sampeln parallel; je größer N und je höher die Abtastrate, desto mehr Bandbreite braucht das Backend;
- Extrem niedrige Latenz: Beamforming und Pulskompression laufen als Pipeline — man kann nicht sammeln und dann rechnen; das Array muss innerhalb jeder Impulsperiode fertig werden, sonst kommt der nächste Impuls.
CPU und GPU liefern diese „Mehrkanal-parallel + Mikrosekunden-Pipeline” nicht deterministisch — genau dafür ist der FPGA da.
Die komplette Radar-Signalverarbeitungskette
Ein typisches digitales Phased-Array-Backend, vom ADC bis zum Zielplot, ist diese Pipeline:
1. Mehrkanal-ADC-Erfassung: ein Kanal pro Element, 12–16 Bit, Abtastraten von Dutzenden bis Hunderten MSPS;
2. DDC digitale Abwärtsmischung: Kanalweise Mischer + Tiefpass + Dezimation zum Basisband-Komplexsignal (I/Q);
3. DBF digitales Beamforming: N Basisband-Streams werden komplex gewichtet und pro Zielrichtung aufsummiert;
4. Pulskompression (angepasster Filter): Anpassen des LFM-Chirp-Signals, um einen breiten Impuls in einen schmalen zu komprimieren und so die Auflösung zu erhöhen;
5. CFAR-Zielerkennung: Ziele auf komprimierten Daten erkennen und Clunterdrückung;
6. Extraktion und Meldung: erkannte Entfernung/Richtung/Amplitude werden gepackt und zum Host geschickt.
Der FPGA nimmt die Schritte 2–5 in eine Taktdomäne und läuft die Kette in jeder Impulsperiode (Dutzende bis Hunderte Mikrosekunden) einmal durch.
Die Datenraten-Rechnung
Ein 16-Kanal-Array mit 125 MSPS und 14 Bit pro Kanal:
| Stufe | Formel | Ergebnis |
|---|---|---|
| Rohrate je Kanal | 125 MSPS × 14 Bit | 1,75 Gbps ≈ 218 MB/s |
| Gesamt, 16 Kanäle | 16 × 1,75 Gbps | 28 Gbps ≈ 3,5 GB/s |
| DDC-Basisband-Komplexrate | 16 ch × 125 MSPS × (16 Bit I + 16 Bit Q) | 8 Gbps ≈ 1 GB/s |
| DBF-Complex-MAC-Durchsatz | 16 ch × 125 M Sample/s × 1 Komplex-MUL | 2 G complex MAC/s |
| 4096-Punkt-Pulskompressions-FFT | 125 MSPS ÷ 4096 | ≈ 30 FFTs je Kanal und Sekunde |
Die Schlüsselzahl: 16 Parallelkanäle, 3,5 GB/s Rohdaten ins Backend. JESD204B/C-Hochgeschwindigkeits-Seriallinks sind genau dafür gebaut — jeder ADC nutzt eine serielle Lane statt eines breiten Parallelbusses.
Was DBF und Pulskompression je kosten
Digitales Beamforming (DBF)
DBF ist im Kern: N komplexe Ströme, jeder mit einem komplexen Gewicht w(n) multipliziert, dann summiert.
- Jeder Abtastpunkt braucht N komplexe Multiplikationen (4 Real-MUL + 2 Additionen);
- Bei N=16 laufen 16 komplexe MULs je Takt parallel — die DSP-Blöcke des FPGA sind natürlich parallel;
- Die Gewichte w(n) werden aus dem Steuerwinkel berechnet (w(n)=e^(-j·2π·n·d·sinθ/λ)) und als Lookup-Tabelle abgelegt.
Der FPGA führt DBF ohne Befehls-Overhead aus — einfach die DSP-Blöcke mit parallelem MAC füllen.
Pulskompression (angepasster Filter)
Das Standardverfahren für LFM-Pulskompression ist die „Frequenzbereichsmethode”: Eingangs-FFT × Filterkoeffizienten → IFFT.
- 4096-Punkt-FFT, eine je Kanal;
- Der FPGA hat fertige gestreamte FFT-IP mit fester Mikrosekunden-Latenz;
- 16 Kanäle können sich einen FFT-Kern teilen oder 16 parallel laufen lassen.
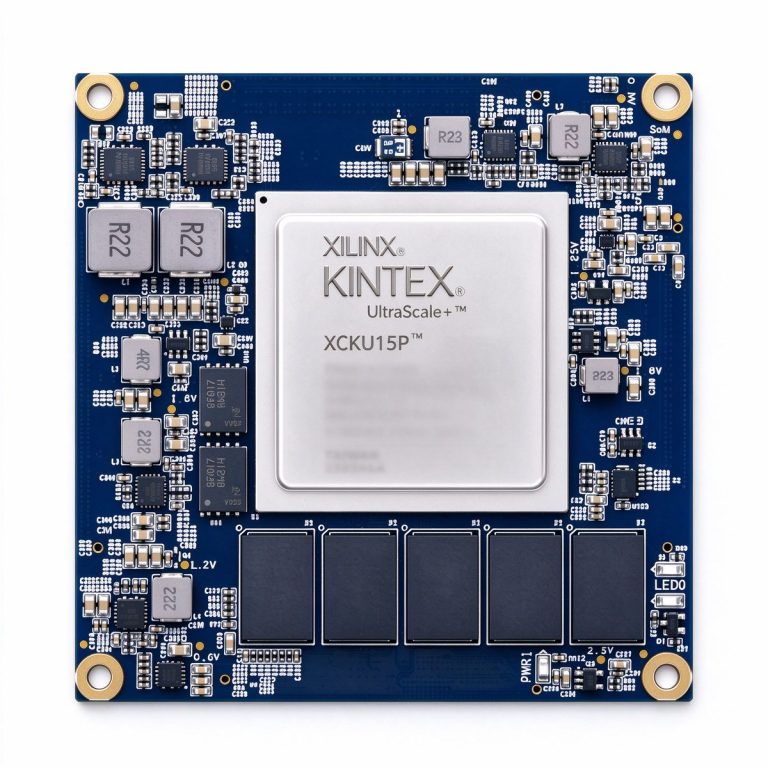
Eine 4096-Punkt-FFT in Einfachpräzision nutzt wenige hundert DSP-Blöcke und wenige Mbit BRAM — passt problemlos auf ein Board wie XCKU15P.
Drei Board-Klassen
Unterschiedliche Kanalzahlen und Aktualisierungsraten brauchen unterschiedliche FPGA-Ressourcen:
| Board | FPGA-Plattform | Radar-Skala | Warum |
|---|---|---|---|
| XCKU15P Core Board | Kintex UltraScale+ | 16–64 Kanäle, hochaktualisierendes Kurzstrecken-Radar | Viel Logik, GTH-Transceiver für mehrere JESD204B/C-Lanes, genug DSP für paralleles DBF + Mehrkanal-FFT |
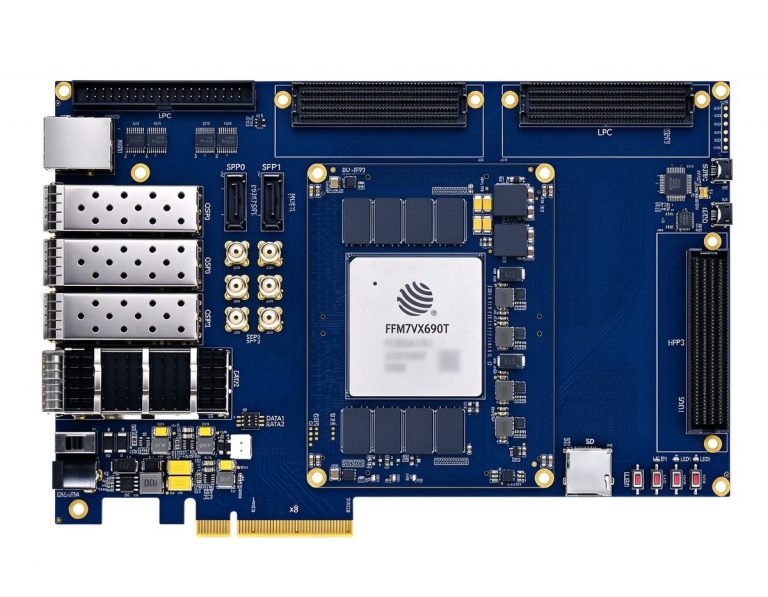
| DUF7690T | FudanMicro JFM7VX690T (kompatibel mit XC7VX690T) | Inländischer hochzuverlässiger Radarknoten | Virtex-7-Klasse, Industrietemperatur, für lieferketten- und zuverlässigkeitskritische Automotive-/Überwachungsradare |
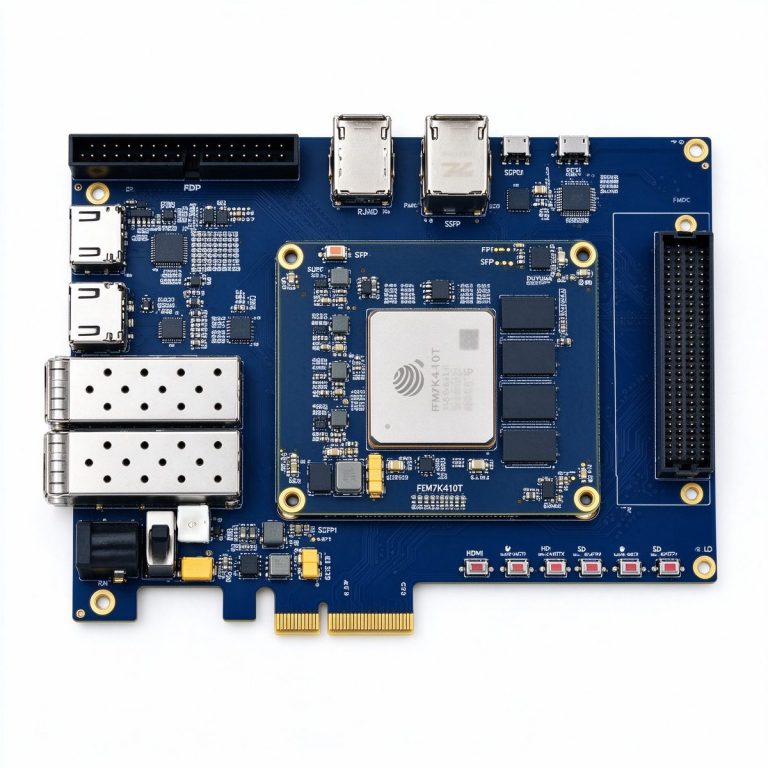
| DUK7410T | FudanMicro JFM7K410T (kompatibel mit XC7K410T) | 4–8 Kanäle, kostengünstige Prototypen | Kintex-7-Klasse, niedrigere Kosten; reicht für Small-Array-DBF und Einkanal-Pulskompression, für Algorithmusvalidierung und Kleinserien |
Typische Aufteilung: Algorithmus-Teams nutzen DUK7410T für 4-Kanal-Prototypen von Wellenform und Erkennung, portieren dann auf DUF7690T für inländische Fertigung oder hoch auf XCKU15P für größere Arrays.
Fallbeispiel: 16-Kanal-Kurzstrecken-Überwachungsradar
Ein Kurzstrecken-Überwachungsradar nutzte ein 16-Element-Lineararray bei 10 GHz, 100 MHz Bandbreite, 5 kHz PRF:
- 16 ADC-Kanäle speisen den FPGA über JESD204B;
- DDC reduziert jeden Kanal auf 10 MHz Basisband-Komplex;
- DBF formt 4 simultane Empfangsstrahlen über verschiedene Azimutwinkel;
- 4096-Punkt-Pulskompression im Frequenzbereich presst einen 20µs-Impuls auf etwa 5 m Entfernungsauflösung;
- Zell-durchschnitt-CFAR meldet Zielplots über PCIe an den Host.
Gemessen: Einzelimpuls-Verarbeitungslatenz etwa 80µs, deutlich unter der 200µs-Impulsperiode; FPGA-Auslastung etwa 60 % (DSP und BRAM).
Das „elektronische Scannen” eines Phased Arrays klingt nach einem Antennenproblem, doch das eigentliche Rechenfeld liegt im FPGA — Mehrkanal-parallel, Mikrosekunden-Pipeline, deterministische Latenz. CPUs können das nicht; FPGAs sind dafür gebaut.
Weiterlesen
- [Breitband-SDR-Frontend: die Hochgeschwindigkeits-Erfassungskette](/article/sdr-wideband-frontend-signal-chain/)
- [10G/25G-Glasfaser-Backhaul: hochbandbreitige Langstrecken-Links](/article/fiber-backhaul-10g-25g/)
- [Taktbaum und Jitter-Budget: Entwurf des Abtasttakts](/article/clock-tree-jitter-budget/)