Wo FPGA, GPU und ASIC die KI-Inferenz-Arbeit aufteilen: Kosten, Leistung und Flexibilität
Das Team möchte eine 1080p-Objekterkennung in ein Gateway integrieren, aber die Finanzabteilung blockt die GPU-Bestellung ab. Wie viel eines quantisierten Modells kann ein FPGA wirklich abbilden? Wann ist eine GPU unverzichtbar? Ab welcher Stückzahl rechnet sich ein ASIC? Dieser Artikel stellt die drei Wege auf eine gemeinsame Kostenrechnung.
1. „Einfach GPU nutzen” ist nicht die einzige Antwort
Denkt man an KI-Inferenz, ist GPU meist der erste Reflex: CUDA-Ökosystem, Operator-Bibliotheken, Modell läuft sofort. Doch sobald es ein echtes Produkt wird, kippt die Rechnung. Eine GPU braucht aktive Kühlung, verbraucht Dutzende Watt, kostet, belegt einen PCIe-Steckplatz und passt nicht ins Gehäuse. In Gateways, eingebetteten Kameras und industriellen Edge-Boxen, wo Baugröße und Leistung knapp bemessen sind, ist eine GPU oft „nutzbar, aber nicht einbaubar”.
Die eigentliche Frage lautet also: Wo ziehen FPGAs und dedizierte ASICs (inkl. NPU/TPU-Beschleuniger) ihre Grenzen? Welches Arbeitslastsegment gehört auf welches Bauteil? Das ist kein „wer ist schneller”-Vergleich, sondern eine Auswahlentscheidung, die von drei Variablen gemeinsam bestimmt wird: Stückkosten, Leistungsaufnahme und Modell-Iterationsfrequenz.
2. Der grundlegende Unterschied: Parallelismus und Datenfluss
Der tiefe Unterschied zwischen den drei Bauteilklassen liegt in der Hardware-Architektur, nicht in einem Benchmark-Wert.
| Dimension | GPU | FPGA | ASIC / NPU |
|---|---|---|---|
| Recheneinheiten | Massives SIMT-Thread-Array | Rekonfigurierbares LUT- + DSP-Array | Festes Systolisch-Array / Tensor-Kerne |
| Datenfluss | Generischer VRAM → SM-Batching | On-Chip-BRAM / Register-Durchlauf | Fester On-Chip-SRAM-Datenfluss |
| Genauigkeit | Starkes natives FP16/FP32 | Anpassbares INT8, schwache Gleitkommazahl | Stark optimiertes INT8/INT4 |
| Latenz | Batch-Warteschlange, ms-Jitter | Feste Pipeline, µs-determiniert | µs, feste Struktur |
| Konfiguration | Treiber + CUDA-Runtime | Place-and-Route-Bitstream | Nach Tape-out unveränderlich |
Eine GPU läuft „jedes Modell”. Ein FPGA leitet Daten durch, ohne auf einen Batch zu warten. Ein ASIC rechnet dasselbe Modell ewig bei höchster Rechenleistung pro Watt. Wer das verinnerlicht, versteht alle Kostenrechnungen im Folgenden.
3. Die Kostenrechnung: NRE, Inferenzkosten, Lebenszyklus
Teilt man die Kosten in drei Abschnitte, weicht das Ergebnis von der Intuition ab.
| Kostenposten | GPU | FPGA | ASIC |
|---|---|---|---|
| Einmalige NRE | Board-Kauf, einige Zehntausend RMB | EDA-Tools + Personal, Personenmonate | Tape-out + Maske, Millionenkategorie RMB |
| Hardware-Kosten pro Inferenz | Hoch (Allgemein-Rechenüberschuss) | Mittel (bedarfsgerecht dimensioniert) | Sehr niedrig (bei Serie amortisiert) |
| Kosten einer Modell-Überarbeitung | CUDA-Kernel neu schreiben, Wochen | Neu synthetisieren, Tage bis Wochen | Unmöglich – neues Tape-out |
| Geeignete Stückzahl | Jedes Volumen | Tausende bis Millionen | Hunderttausende+ |
Der entscheidende Zusammenhang ist die NRE-Amortisation: FPGA-NRE ist vor allem Ingenieurszeit und amortisiert sich nicht über den Stückpreis. ASIC-NRE ist enorm, aber die Stückkosten brechen mit steigender Stückzahl ein. Eine Faustregel: Bei Jahresstückzahlen zwischen einigen Tausend und Zehntausend Einheiten ist FPGA meist das Kostenoptimum. Erst bei Hunderttausenden pro Jahr und einem Modell, das 2–3 Jahre stabil bleibt, beginnt sich die ASIC-NRE zu rechnen.
4. Leistung und Kühlung: die empfindlichste Edge-Kenngröße
In Edge-Geräten bestimmt die Leistungsaufnahme direkt die Kühlung und die Gehäusegröße.
| Weg | Typische Inferenzleistung | Kühlung |
|---|---|---|
| High-End-GPU (Inferenzkarte) | 35–70 W | Aktiver Lüfter |
| Mittel-/Niedrig-GPU / iGPU | 10–25 W | Passive Luftkühlung |
| Mittel-/Groß-FPGA | 8–25 W (unter 5 W skalierbar) | Passive Kühlkörper |
| Dedizierte NPU / ASIC | 2–8 W | Passive Kühlkörper |
Der FPGA-Leistungsvorteil liegt nicht in höherer Spitzenrechenleistung, sondern darin, dass man jede nicht benötigte Logik entfernen kann. Nur die für die Objekterkennung nötigen Conv-Kerne, das Quantisierungs-Backend und die DMA-Kanäle behalten. Ein Kintex-FPGA, der INT8-Detection rechnet, bleibt oft unter 10 W Gesamtboard-Leistung. Das ist in einem lüfterlosen Industrie-Edge-Box entscheidend.
5. Flexibilität und Iterationstempo: der Preis von Modell-Updates
Industrielle KI-Projekte rechnen selten beim ersten Versuch ab. Algorithmenteams tauschen Backbones, Quantisierungsstrategien und Nachverarbeitung jedes Quartal aus. Hier gehen die drei Welten weit auseinander:
- GPU: PyTorch → TensorRT-Neuexport; nicht unterstützte Operatoren bedeuten handgeschriebene Kernel; eine Anpassung dauert Stunden bis Tage.
- FPGA: Quantisierte Netzwerke zu RTL-Pipeline gehärtet; erneutes Synthese- und Place-and-Route dauert Stunden; ein neuer Operator bedeutet RTL- oder HLS-Arbeit, wenige Personentage.
- ASIC: Der Chip ist versiegelt. Eine Modelländerung bedeutet Software-Patches obenauf; echte Strukturänderungen warten auf den nächsten Chip.
Die Schlussfolgerung ist direkt: Berühre keinen ASIC, solange das Modell noch schnell iteriert. Der FPGA ist das einzige Sweet-Spot, wo man hardware-level-Determinismus braucht, aber weiß, dass sich das Modell in sechs Monaten ändert.
6. Eine Entscheidungsmatrix: welches Szenario, welcher Weg
Die drei Linien in eine vergleichbare Matrix zusammengefasst:
| Szenario | Empfohlener Weg | Begründung |
|---|---|---|
| Cloud-Batch-Inferenz, häufige Modell-Updates | GPU | Ökosystem und Durchsatz zuerst |
| Edge-Box, unter 10 W, deterministische Latenz | FPGA | Beste Leistung und Determinismus |
| Kamera-integriert, 100k+ Jahresstück, Modell stabil | ASIC/NPU-SoC | Niedrigste Stückkosten |
| Labor-Prototyp, Demo schnell zum Laufen bringen | GPU | Schnellste Entwicklung |
| Multi-Protokoll + AI auf einem Chip | FPGA | Programmierbare Logik, kein zweiter Bridge-Chip |
Ein häufiger Fehlschluss: bei „KI” automatisch auf GPU setzen. In Szenarien, in denen „KI-Vorverarbeitung + Echtzeit-Geschäftslogik” zusammenlaufen – etwa Bildverbesserung, Detection, GbE-Erfassung und GPIO gleichzeitig – ist ein FPGA die wirtschaftlichste Art, alle drei auf einem Die zu vereinen. Eine GPU übernimmt nur den KI-Anteil und zwingt zu einem zusätzlichen Host-MCU für die Protokoll-Brücke.
7. Wo die drei Duyuan-Boards in die Raster fallen
Die Matrix auf Duyuans aktive Boards abgebildet:
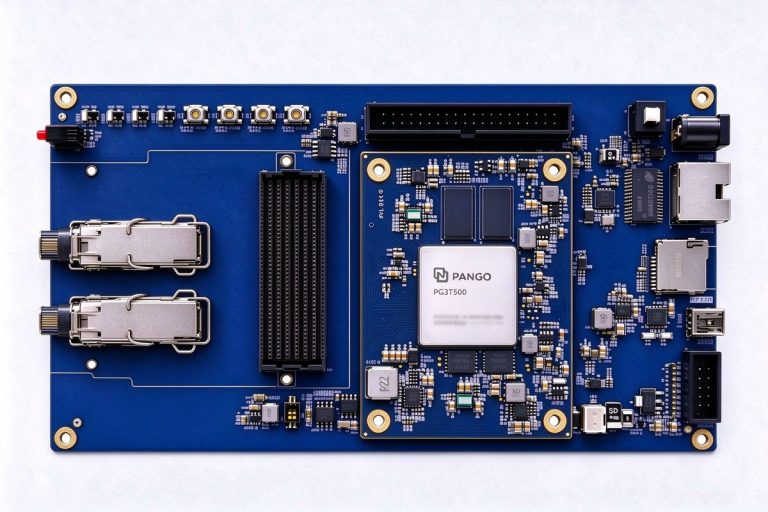
- DUPG3T500 (Pango Titan3, ~¥5.999): Eine nationale High-End-FPGA-Entwicklungsplattform, geeignet für Algorithmenteams zur Hardware-Prototypenentwicklung von INT8-quantisierten Modellen und zur Direktumsetzung von Kleinserien-Gateway-Produkten.
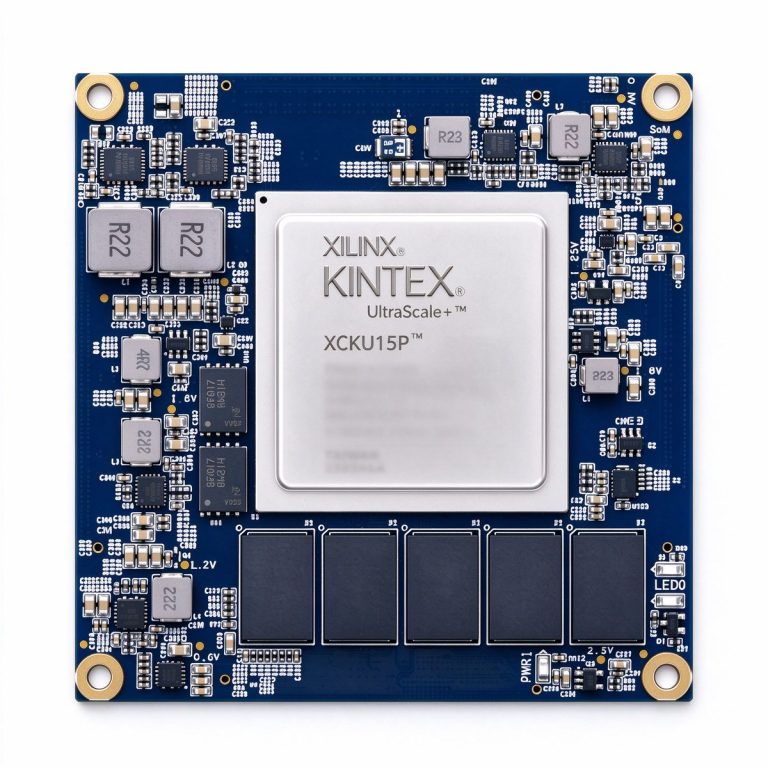
- DUKU15P (Xilinx Kintex UltraScale+ XCKU15P SOM, ~¥17.999): Große Logik-Fläche + Hochgeschwindigkeits-Transceiver, für Mittel- bis Highend-Produkte mit KI-Inferenz neben mehreren 10G-Datenkanälen.
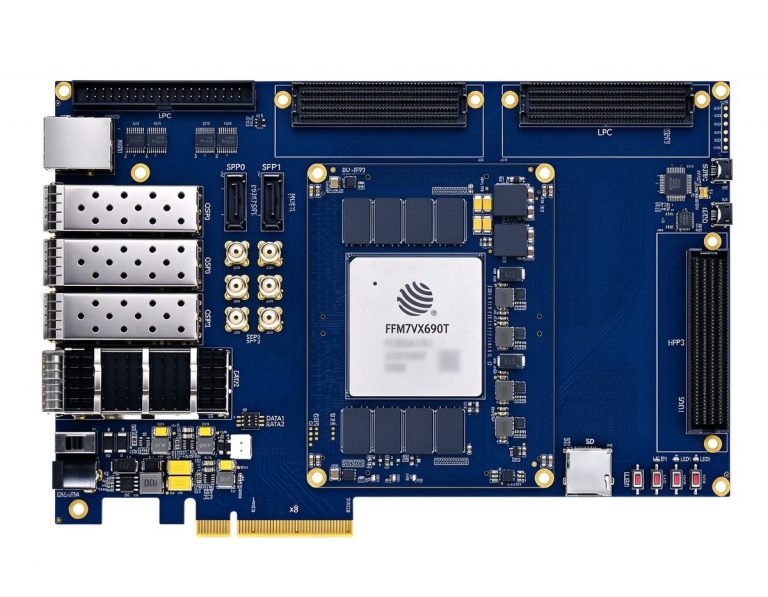
- DUF7690T (FudanMicro JFM7VX690T, kompatibel mit XC7VX690T, ~¥24.999): Industrielle nationale Virtex-7-Plattform für gehärtete Inferenz und langfristige Lieferung in Hochzuverlässigkeitsanwendungen.
| Board | Positionierung | Typische KI-Arbeitslast |
|---|---|---|
| DUPG3T500 | Prototyp / Kleinserien-Gateway | INT8-Detection, Klassifizierung |
| DUKU15P | Mittel-High + Hochgeschwindigkeits-I/O | Mehrkanal-Detection + 10G-Uplink |
| DUF7690T | Industrielanger Lebenszyklus | Gehärtetes Modell + Hochzuverlässigkeitslieferung |
8. Checkliste für die Umsetzung
Geht ein Edge-KI-Projekt in dieser Reihenfolge an, vermeidet man die meisten Nacharbeiten:
- Zuerst Latenz- und Leistungsbudget festlegen, dann Rechenleistung zurückrechnen: Lüfterlose Edge-Geräte deckeln bei 5–15 W Gesamtleistung, GPU ist damit raus.
- Das Modell zuerst auf GPU abstimmen, auf INT8 quantisieren, dann über eine Härtung auf FPGA nachdenken – Algorithmen nie auf FPGA entwickeln.
- Jahresstückzahl unter 100k, Modell ändert sich innerhalb eines Jahres: FPGA wählen; in dieser Phase ASIC gar nicht diskutieren.
- Jahresstückzahl Hunderttausende, Modell über zwei Generationen stabil: dann erst die ASIC/NPU-NRE-Analyse starten.
- Wenn Erfassung, Protokoll und KI auf einem Produkt zusammenfallen, zuerst Single-Chip-FPGA-Integration prüfen, statt GPU + Host-MCU.
Die Wahl des Inferenz-Bauteils dreht sich nicht darum, „wer die größten FLOPs hat”. Es geht darum, wer die Stückkostenrechnung im Spannungsfeld aus Leistungsbudget und Modell-Iterationsrhythmus gewinnt. Der FPGA ist kein GPU-Ersatz – er besetzt die Edge-Position, wo die Rechnung tatsächlich aufgeht.
Weiterlesen
- Wie wählt man einen FPGA: Ressourcen × Transceiver × Preis-Entscheidungsmatrix
- Mehrkamera-Board-KI-Inferenz: die Edge-Bereitstellungsrechnung
- MPSoC vs reiner FPGA vs MCU+ARM: drei heterogene Wege im Vergleich