VU13P im quantitativen Handel: Eine Low-Latency-Hardwareplattform von der Marktdaten-Dekodierung bis zur Orderausführung
Das Wesen des quantitativen Handels besteht darin, den Informationskreislauf „Marktdatenankunft → Signalberechnung → Orderübermittlung” in kürzester Zeit zu schließen. Dieser Artikel nimmt die AMD-Virtex-UltraScale+-XCVU13P-Plattform (VU13P) als Leitlinie und erklärt, warum sie sich für den quantitativen Handel eignet und wie sie sich in eine lieferbare Low-Latency-Handelskette integrieren lässt.
Das Wesen des quantitativen Handels besteht darin, den Informationskreislauf „Marktdatenankunft — Signalberechnung — Orderübermittlung” in kürzester Zeit zu schließen. Im Mikrosekunden-Takt einer Börsen-Matching-Engine ist Latenz selbst ein Kostenfaktor: eine Mikrosekunde zu spät bedeutet Preisslippage, verpasste Gelegenheiten oder das Scheitern einer gesamten Strategie. In den letzten gut zehn Jahren haben führende Proprietary-Trading-Häuser die kritischsten Teile der Kette schrittweise von CPU-Software auf FPGA-Hardware verlagert — Marktdaten-Dekodierung auf der Karte, Orderbuch auf der Karte, Strategieentscheidungen auf der Karte, Ordergenerierung auf der Karte. Dieser Artikel nimmt die AMD-Virtex-UltraScale+-XCVU13P-Plattform (VU13P) als Leitlinie und erörtert, warum sie sich für den quantitativen Handel eignet und wie sie sich in eine lieferbare Low-Latency-Handelskette integrieren lässt.
1. Die Latenzstruktur des quantitativen Handels: Warum die Antwort FPGA lautet
Eine typische automatisierte Handelskette — vom Eintreffen eines Marktdatenpakets an der NIC bis zum Verlassen einer Order aus der NIC — durchläuft nacheinander Netzwerk-Stack, Marktdaten-Parsing, Orderbuch-Pflege, Signalberechnung, Risikoprüfung und Orderkodierung. Im Software-Stack führen Kernel-Interrupts, Protokoll-Stack-Verarbeitung, Thread-Scheduling und Cache-Misses zu unkontrollierbarem Jitter; die Hardware-Implementierung verwandelt diese Stufen in eine feste Pipeline-Tiefe mit deterministischer Latenz, ohne Interrupts und ohne Scheduling. Die ungefähre End-to-End-Tick-to-Trade-Latenz verschiedener Implementierungsansätze:
Tabelle: Vergleich der End-to-End-Tick-to-Trade-Latenz (aus öffentlichen Quellen zusammengestellt)
| Implementierung | Typische End-to-End-Latenz |
|---|---|
| Gewöhnliche Software + Kernel-Netzwerk-Stack | 10–100 µs |
| Kernel-Bypass-Software (DPDK / Onload + Core-Pinning) | 1–5 µs |
| Vollständige FPGA-Kette (Parsing → Strategie → Order) | 300 ns – 1 µs |
| FPGA-vorbereiteter Trigger (Mustererkennung und Senden) | 30–100 ns |
| Layer-1-Switch (reine Fan-out-/Replikation) | ca. 5 ns |
Drei Eigenschaften des FPGA bestimmen diesen Größenordnungsunterschied: Parallelität — mehrere Marktdaten-Feeds und Strategieinstanzen laufen gleichzeitig in der Hardware, ohne sich zu konkurrenzieren; Determinismus — keine Interrupts oder Scheduling, die Verarbeitungslatenz jedes Pakets ist fest, was für Risikokontrolle und Audit gleichermaßen wichtig ist; Nähe — optische Ports gehen direkt ins FPGA, unter Umgehung von PCIe und Protokoll-Stack, Pakete werden beim Eintreffen dekodiert. Öffentliche Branchendaten bestätigen dies: bestimmte Lösungen werben mit einer Round-Trip-Tick-to-Trade-Latenz unter 100 ns, die Referenzlösung von AMD mit Partnern für CME erreicht eine vorbereitete Trigger-Latenz auf 25-ns-Niveau; ein 2025 in *Computer Applications and Software* veröffentlichter Artikel über ein auf OpenCL basierendes Ultra-Low-Latency-Marktdaten-Beschleunigungssystem erreichte auf einem Alveo U50 eine minimale Marktdatenverarbeitung von 678 ns bei 38,4 Gbit/s Durchsatz, etwa 12-fache Leistungsverbesserung gegenüber dem Software-Ansatz.
2. Überblick über die VU13P-Plattform
VU13P gehört zur AMD-Virtex-UltraScale+-Familie und ist ein repräsentatives Bauelement am Balancepunkt „Logikskalierung × Hochgeschwindigkeitsschnittstelle”. Laut offizieller AMD-Produktdokumentation sind die wichtigsten Spezifikationen:
Tabelle: Wichtige Spezifikationen des XCVU13P (Quelle: offizielle AMD-Virtex-UltraScale+-Produktseite)
| Kennwert | XCVU13P-Spezifikation |
|---|---|
| System Logic Cells | 3.780K (ca. 3,78 Millionen Logikzellen) |
| DSP-Slices | 12.288 |
| GTY-Hochgeschwindigkeitstransceiver | 128 Paare (bis zu 32,75 Gb/s pro Paar) |
| User-I/O | 832 |
| Integrierte Hochgeschwindigkeitsschnittstellen | PCIe Gen3 x16, 100G-Ethernet-MAC, 150G Interlaken (Hard-Blocks im Die) |
| DSP-Rechenleistung | bis zu ca. 38 TOP/s |
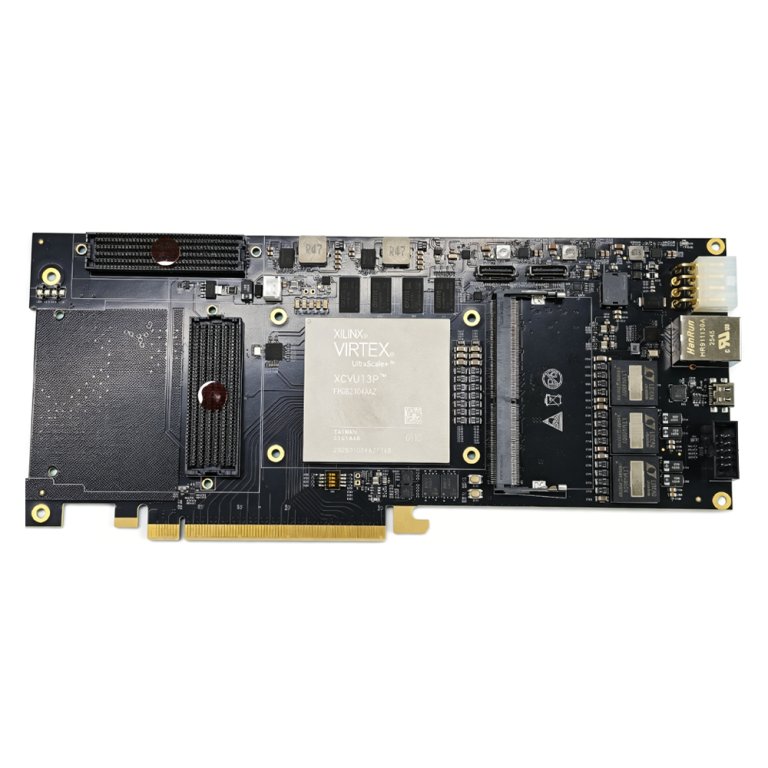
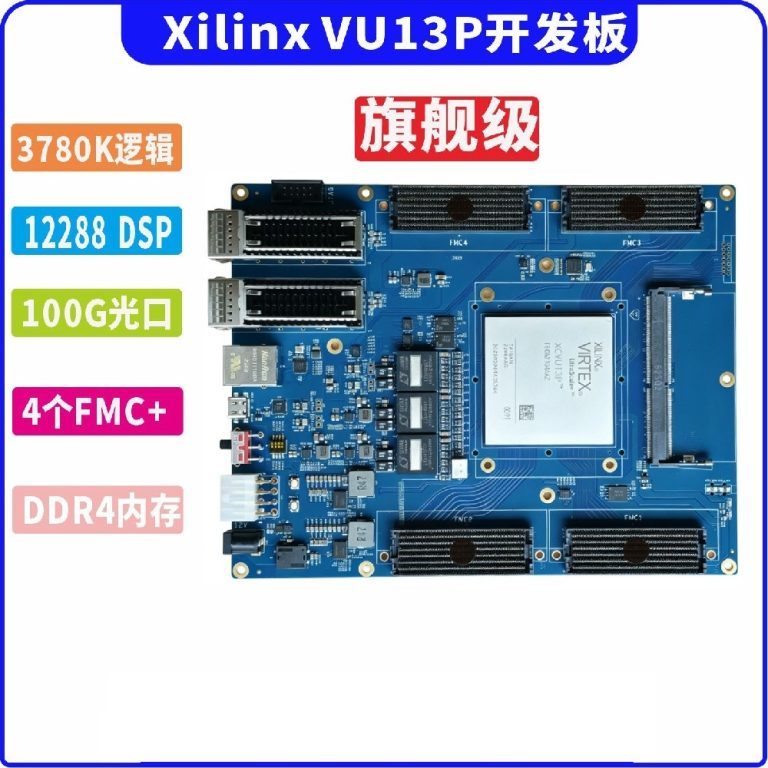
Auf Board-Ebene bietet die VU13P-Ultra-High-End-Entwicklungsplattform von Duyuan Electronics PCIe-Gen3-x16-Goldfinger, mehrere 100G-Optikports (QSFP28), FMC+-Hochgeschwindigkeitserweiterung, DDR4-SODIMM-Erweiterung und einen industriellen Temperaturbereich von -40 °C bis 85 °C. Für den quantitativen Handel bietet diese Karte naturgemäß drei Dinge: mehrere Börsen-Feeds direkt in das FPGA (Optikports + GTY), umfangreiche Strategielogik im FPGA (3,78 Millionen Logikzellen + 12.288 DSP) und hochbandbreitige bidirektionale Host-Anbindung (PCIe Gen3 x16).
3. Vier Kernanwendungen der VU13P in der quantitativen Handelskette
3.1 Marktdaten-Dekodierung und Vorverarbeitung (Feed Handler)
Börsen-Marktdatenprotokolle (NASDAQ ITCH, CME MDP3, das an europäischen Börsen übliche FAST-Format usw.) treffen mit extrem hohen Paketraten ein; Software-Parsing erfordert paketweises Dekodieren, Validieren und Strukturrekonstruktion und ist damit der früheste und typischste Engpass der Kette. Auf der VU13P wird Marktdaten-Parsing als Hardware-Pipeline implementiert: Pakete werden beim Eintreffen am Optikport als Bytestrom dekodiert, Feldextraktion, Validierung und Protokoll-Rekonstruktion erfolgen in festen Pipelinestufen, während mehrere Feeds (mehrere Börsen, A/B-Haupt-/Backup-Leitungen) parallel verarbeitet werden. Die 128 GTY-Transceiver und mehrere 100G-Optikports bieten ausreichend Kapazität für gleichzeitige Anschlüsse; für Börsen mit Haupt-/Backup-Doppelleitungen (z. B. CME A/B-Leitungen) können Leitungsarbitrierung und nahtloser Failover in Hardware implementiert werden, um Marktdatenlücken durch Einzelleitungs-Jitter zu vermeiden. Die geparsten Standard-Marktdatenstrukturen werden direkt in On-Chip-Speicher geschrieben und stehen nachgelagerten Strategiemodulen zur Verfügung, ohne jemals durch die Host-CPU zu gehen.
3.2 Hardware-Orderbuch und parallele Strategieausführung
Die Pflege eines abfragbaren Orderbuchs erfordert häufige Einfüge-, Lösch-, Änderungs- und Sortieroperationen; Software-Implementierungen stützen sich auf Speicherzugriff und Sperren, Hardware-Implementierungen bilden Preisebenen direkt auf On-Chip-Block-RAM-Strukturen ab, wobei Preissuche und Matching-Entscheidungen in festen Zyklen erfolgen. Auf dieser Basis erlauben die 3,78 Millionen Logikzellen der VU13P mehrere Strategieinstanzen parallel auf einem Bauelement: verschiedene Instrumente, verschiedene Märkte und sogar verschiedene Strategielogiken (Market Making, Cross-Market-Arbitrage, Latenz-Arbitrage, statistische Regression) können unabhängige Logikpartitionen belegen und denselben geparsten Marktdatenstrom teilen, ohne sich zu stören. Für latenzempfindliche Trigger-Strategien kann ein „vorbereiteter Order”-Ansatz verwendet werden: Ordervorlagen werden vorab in den Sendepuffer geschrieben; wenn die Hardware die gesetzte Bedingung erkennt (Preisdurchbruch, Volumenverhältnisänderung), löst sie das Senden direkt aus und umgeht den Software-Entscheidungspfad, wodurch die Latenz auf Dutzende Nanosekunden komprimiert wird.
3.3 Pre-Trade-Risiko
Börsen und Compliance-Rahmenwerke stellen immer strengere Anforderungen an algorithmischen Handel: Preisbandbreite, Einzelorder-Mengenlimits, kumulative Tagesposition, Orderfrequenz und weitere Prüfungen müssen vor dem Senden einer Order abgeschlossen sein. Das Problem von Software-Risikoprüfungen besteht darin, dass sie selbst auf dem kritischen Pfad liegen und Latenz hinzufügen; FPGA-Risikoprüfungen legen die Prüflogik parallel zum Orderpfad — jede Order durchläuft mehrere Risikoprüfstufen in der Hardware-Pipeline und wird bei Bestehen sofort kodiert und gesendet, bei Ablehnung in Nanosekunden blockiert. Risikoregeln werden über Register/Speichertabellen konfiguriert und können innerhalb des Handelstags heiß aktualisiert werden, was Compliance-Anforderungen erfüllt, ohne die niedrige Latenz des Hauptpfads zu opfern.
3.4 Backtesting, Simulation und F&E-Beschleunigung
Über die Produktionskette hinaus unterstützen die großen Logikressourcen der VU13P auch die Strategie-F&E: Laden Sie Marktdaten-Replay- und Simulations-Engines auf das Entwicklungsboard für Hardware-Backtesting mit historischen Daten, mehrere Strategien parallel — deutlich schneller als Softwaresimulation; nutzen Sie Vivado/Vitis HLS, um C/C++-Algorithmen schnell auf Hardware-Implementierungen abzubilden und den Iterationszyklus „Strategieidee → testbare Hardware” zu verkürzen. Eine typische Ingenieursorganisation ist „FPGA für den Produktionspfad, CPU für Monitoring und Analyse”: Produktionsorder und Marktdatenverarbeitung laufen vollständig auf der Karte, der Host liest über PCIe Gen3 x16 den Status und lädt Strategieparameter und Risikoregeln, was Leistung und Betrieb gleichermaßen ausbalanciert.
4. Typische End-to-End-Systemarchitektur
Eine VU13P-basierte Plattform für quantitativen Handel hat eine typische Topologie:
- Marktdaten-Eingang: Börsen-Feeds gehen direkt über 100G-Optikports (QSFP28) ins FPGA, 128 GTY-Paare tragen mehrere Leitungen;
- Hardware-Parsing: Feed-Handler-Module dekodieren, validieren und arbitrieren A/B-Leitungen pipelineartig nach Protokoll (ITCH/FAST/MDP3 usw.);
- Orderbuch und Signale: On-Chip-BRAM pflegt Orderbücher für mehrere Instrumente, Strategiepartitionen berechnen Signale parallel, Orders werden bei erfüllten Triggerbedingungen generiert;
- Risiko und Kodierung: Orders passieren Pre-Trade-Risikoprüfungen und werden in Börsenprotokoll-Nachrichten kodiert, bevor sie in den Sendepuffer gelangen;
- Host-Anbindung: Orderbestätigungen, Ausführungsmeldungen und Statusmonitoring gehen über PCIe Gen3 x16 an den Host; Strategieparameter und Risikoregeln werden vom Host geladen;
- Erweiterungsschnittstellen: FMC+ dient zum Anschluss benutzerdefinierter NICs/Beschleuniger-Tochterkarten, OCULINK für Board-zu-Board-Hochgeschwindigkeitsverbindungen zur Mehr-Board-Skalierung.
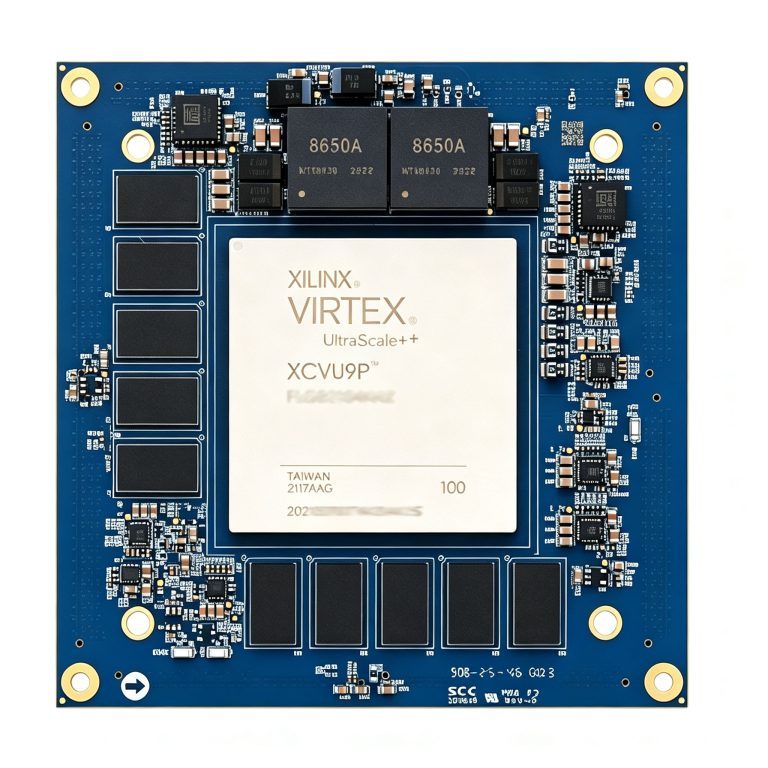
In der Bereitstellungsform kann das VU13P-Entwicklungsboard direkt als PCIe-Beschleunigerkarte in einem Server dienen; für raum- und leistungssensible Szenarien kann auf Basis dieser Plattform eine leistungsärmere Core-Board-Formfaktorvariante angepasst werden.
5. Technische Vorteile der VU13P gegenüber anderen Ansätzen
Tabelle: Vergleichsperspektive quantitativer Handelshardware-Plattformen
| Dimension | Relativer Vorteil der VU13P (FPGA) |
|---|---|
| End-to-End-Latenz | volle Kette 300 ns – 1 µs, Pre-Trigger 30–100 ns; Software-Ansätze typischerweise 1–100 µs |
| Latenzdeterminismus | feste Pipeline-Tiefe, kein Interrupt-/Scheduling-Jitter, gut für Risiko und Audit |
| Parallelkapazität | 3.780K Logikzellen + 12.288 DSP, mehrere Strategien/Instrumente gleichzeitig |
| Schnittstellenbandbreite | 128×GTY, mehrere 100G-Optikports, PCIe Gen3 x16, direkter Multi-Börsen-Feed |
| Flexibilität | rekonfigurierbar: Strategieänderungen sind Konfiguration/Reload, kein Boardwechsel; viel kürzere Entwicklungszyklen als ASIC |
| Entwicklungsschwelle | niedriger als ASIC; Vitis HLS/OpenCL bildet aus C/C++ ab, Schlüsselpfade zusätzlich in RTL optimiert |
Im Vergleich zur CPU: VU13P liegt bei Latenz und Determinismus eine Größenordnung vorn; im Vergleich zur GPU: GPUs glänzen beim Batch-Durchsatz, aber Pipeline und Scheduling verursachen Latenz-Jitter, der sie für nanosekundenkritische Pfade ungeeignet macht, während die deterministische Latenz der VU13P naturgemäß passt; im Vergleich zum ASIC: ASICs bieten die beste Leistung, aber prohibitive Einmalkosten und Entwicklungszyklen, geeignet nur für vollständig eingefrorene Algorithmen, während die VU13P Flexibilität für Strategieentwicklung behält. Genau deshalb ist „FPGA für den kritischen Pfad, CPU/GPU für Forschung und Offline-Berechnung” die Standard-Arbeitsteilung bei Proprietary-Trading-Häusern.
6. Entwicklungs- und Bereitstellungshinweise
- Toolchain-Aufteilung: kritische Pfade (Protokoll-Parsing, Orderkodierung) verwenden RTL zur Latenzgarantie; Strategielogik kann schnell mit Vitis HLS / OpenCL implementiert werden, zunächst Verhalten in Softwaresimulation validieren, dann auf Hardware synthetisieren;
- Modulare Schnittstellen: Feed Handler, Order Book, Strategy, Risk und Gateway verwenden einheitlich AXI-Stream-Datenschnittstellen, was Austausch, Wiederverwendung und Teamarbeit erleichtert;
- Takt und Synchronisation: in Mehr-Board-/Mehr-Standort-Bereitstellungen PTP/1PPS und einen Low-Jitter-Taktbaum einführen, um die Zeitbasis zu vereinheitlichen und Ausführungsmeldungen mit Marktdaten-Zeitstempeln abzugleichen;
- Mit einem Standard-Board beginnen: zuerst Marktdaten-Parsing und Strategievalidierung auf dem VU13P-Entwicklungsboard abschließen, die Latenzkette durchlaufen, dann den Board-Formfaktor (Schnittstellenanzahl, Leistung, Mechanik) nach Projektanforderungen anpassen;
- Monitoring und Regression: Statistikzähler und ILA-Beobachtungspunkte in der Hardware-Logik behalten, Pipeline-Latenz pro Stufe während des Handelstags überwachen, jede Verschlechterung ist schnell lokalisierbar.
7. Grenzen und Auswahlempfehlungen
FPGA ist nicht für jedes quantitative Szenario die Antwort. Wenn eine Strategie im Minuten- oder Stundenrhythmus umschichtet oder auf umfangreiche maschinelle Lernmerkmale mit häufigen Iterationen komplexer Modelle angewiesen ist, sind die Kosten- und Flexibilitätsvorteile des CPU/GPU-Software-Stacks offensichtlicher; wenn dem Team Hardware-Entwicklungsfähigkeiten fehlen, ist der Evaluierungs-, Debugging- und Wartungszyklus eines FPGA-Projekts großzügig einzuplanen. Wenn Hardware-Low-Latency als Anforderung bestätigt ist, kann die Bauelementauswahl nach Ressourcenbedarf geschichtet werden:
- VU9P: 2.586K Logikzellen, 6.840 DSP, mit 2×200G + 4×100G-Optikports, 32 GB DDR4 ECC, PCIe x16 — geeignet für Szenarien mit großem Marktdaten-Eingang und Schwerpunkt auf Speicher/Bandbreite;
- VU13P: 3.780K Logikzellen, 12.288 DSP, 128×GTY — geeignet für parallele Multi-Strategien, komplexe Strategielogik und Szenarien mit größerem On-Chip-Ressourcenbedarf; die umfassende Hauptplattform dieser Anwendungsklasse;
- VU13F: ebenfalls 12.288 DSP, mit 4×FMC+ für umfangreiche erweiterbare I/Os und Tochterkartenschnittstellen — geeignet für systemnahe Integration mit benutzerdefinierten NICs, HF-Frontends und anderer externer Hardware.
Hinweis: Die Latenzwerte in diesem Artikel sind typische Bereiche aus öffentlichen Quellen; die tatsächlichen Werte hängen von Protokollen, Paketraten, Strategieimplementierung und Board-Routing ab. Auswahl und Abnahme sollten auf Messungen vor Ort basieren.
8. Fazit
Die Hardware-Isierung des quantitativen Handels ist ein seit Jahren sicherer Trend: von der frühesten NIC-Entlastung über die Verlagerung von Marktdaten-Parsing und der gesamten Orderkette auf FPGA bis heute, wo ein einziges Bauelement der VU13P-Klasse gleichzeitig Mehr-Markt-Daten, Multi-Strategien und Risikokontrolle trägt. Der Wert der VU13P liegt darin, „Skalierung” und „Geschwindigkeit” auf dasselbe Bauelement zu bringen — genug Logik und DSP für komplexe Strategiekombinationen, die parallel in Hardware laufen, und genug GTY- und 100G-Optikports, sodass Multi-Börsen-Eingang kein Engpass mehr ist. Duyuan Electronics bietet VU13P/VU9P-Standardentwicklungsboards, kundenspezifische Core-Boards, IP-Pakete für Marktdaten-Dekodierung und Low-Latency-Ketten sowie durchgängigen technischen Support und hilft Teams, schnell von der Evaluierungsboard-Validierung zu einer einsatzbereiten quantitativen Handelshardware-Plattform zu gelangen.
Referenzen
- AMD, Virtex-UltraScale+-FPGA-Produktseite (XCVU13P-Spezifikationen): https://www.amd.com/en/products/adaptive-socs-and-fpgas/fpga/virtex-ultrascale-plus.html
- AMD/Xilinx mit LDA, CME-Tick-to-Trade-Referenzlösung mit 25 Nanosekunden: https://www.xilinx.com/publications/solution-briefs/partner/xilinx-lda-amd-tick-to-trade-solution-brief.pdf
- libfpga, FPGAs in high-frequency trading: the anatomy of a nanosecond (Tick-to-Trade-Latenzvergleich): https://libfpga.com/blog/fpgas-for-hft
- semidesignjobs, FPGAs in High-Frequency Trading: A Technical Deep Dive: https://www.semidesignjobs.com/blog/fpga-hft-technical-deep-dive
- Enyx, nxFramework (Sub-100-ns-Tick-to-Trade-Plattform): https://www.enyx.com/nxframework/
- Computer Applications and Software 2025, Design und Implementierung eines auf OpenCL basierenden Ultra-Low-Latency-Marktdaten-Beschleunigungssystems: https://shcas.net/cn/article/doi/10.3969/j.issn.1000-386x.2025.03.003
- ACM, DSL Programmable Engine for High Frequency Trading Acceleration (FAST-Protokollbeschleunigung): https://dl.acm.org/doi/pdf/10.1145/2088256.2088268
Duyuan Electronics · Anwendungspraxis | Datenstand September 2026; die Abgrenzungen verschiedener Institute unterscheiden sich, alle Quellen sind annotiert